litek8s ui: el entorno de desarrollo en una terminal
litek8s ui es la respuesta de litek8s a las ventanas de OrbStack y Docker
Desktop: ver, configurar y operar el entorno de desarrollo local sin tener que
recordar comandos. Es parte del mismo binario, se maneja con el teclado, cabe en
una terminal de 80x24 y funciona igual en local que por SSH:
litek8s ui # los clusters de desarrollo de esta máquinalitek8s ui --cluster ci # empezando en el cluster local `ci`ssh -t box litek8s ui # los de otra máquina, en tu terminalNueve vistas, 1-9 (o tab) para cambiar entre ellas, y una décima, 0, en
los clusters que corren Argo CD o litecd; ? para las teclas de cada una:
| vista | qué te da |
|---|---|
| 1 Home | el estado del cluster mostrado (up, down, starting, stopping), modo, uptime; su CPU, memoria y disco frente a lo que tiene la VM o el sandbox rootless; en una caja propia, los contenedores, imágenes y volúmenes del socket de Docker y lo que ocupan; el API server; si docker y kubectl apuntan a él. u up, d down, R borrar (pregunta antes) |
| 2 Clusters | los clusters locales (estado, puerto de la API, nodos, memoria, antigüedad) y los demás contextos de tu kubeconfig; n nuevo (nombre, nodos), u/d up/down, D borrar, enter lo muestra en todas las vistas (y ofrece apuntar kubectl y docker a él); ver Clusters |
| 3 Containers | docker ps -a, agrupado por proyecto de compose, con la memoria de cada proyecto frente a su presupuesto, CPUs y OOM kills: l logs (follow), s una shell en el contenedor, u/x/r iniciar/detener/reiniciar, d eliminar; en la fila de un proyecto actúan sobre todo el proyecto, space lo pliega |
| 4 Images | tamaños, antigüedad, qué contenedores y pods usan cada una; d eliminar |
| 5 Volumes | tamaños, qué contenedores monta cada uno, proyecto de compose; d eliminar |
| 6 Free space | lo que se puede recuperar: contenedores detenidos, imágenes dangling, build cache, imágenes sin usar, volúmenes sin usar; selecciona con space, p lo libera |
| 7 Kubernetes | una UI de cluster para cualquier cluster o contexto (litek8s, k3s, EKS, GKE, …), al estilo de k9s: : cualquier recurso (CRDs también), / filtros y selectores, describe, YAML, edición con un dry run en el servidor y un diff, logs de pods y de workloads completos, shells, port-forwards, árboles xray; ver Kubernetes |
| 8 Settings | CPUs, memoria, el disco de la VM (crece en el lugar), directorios compartidos, puerto de la API, dónde escuchan los puertos publicados; cambia los contextos de docker y kubectl a litek8s y de vuelta; edita el archivo de configuración en $EDITOR |
| 9 Observe | las alertas del cluster y sus pods por CPU o memoria con sparklines de los últimos 30 minutos, a partir de las métricas integradas del API server; todos los logs de un pod (incluidos los contenedores que ya no existen), una búsqueda por regex en los logs de todos los pods, reconocer alertas; ver Observar y observability.md |
| 0 Apps | solo donde el cluster sirve applications.argoproj.io: las Applications de Argo CD (ejecutadas por Argo CD o por litecd) con sync, health, revisión, último sync y lo que dice la operación; los recursos de una app, su historial de sync y el último resultado; sync (con prune, y force en Argo CD), refresh, hard refresh, terminar un sync (Argo CD); ver Apps |
Todo lo que borra o detiene pregunta antes, y dice qué se va: eliminar un proyecto de compose lista sus contenedores, borrar un cluster dice que borra cada objeto, imagen y volumen y dónde están, liberar espacio suma lo que libera.
Aspecto
Sección titulada «Aspecto»La UI se dibuja con el espíritu de btop:
cajas redondeadas con sus títulos insertos en el borde, un encabezado con las
pestañas y la insignia del cluster mostrado (estado, modo, uptime), medidores
que van de verde a rojo pasando por amarillo con precisión de un octavo de
celda, gráficos de historial para CPU y memoria, desgloses como barras en
línea, y los mismos glifos de estado en todas partes: ● corriendo, ◐
pendiente o arrancando, ✕ fallido o en crash, ○ completado o terminado.
Las listas tienen encabezados en negrita, texto secundario atenuado, filas
coloreadas según su estado (sin color mientras todo está bien, amarillo en
camino, rojo cuando fallan, atenuadas cuando terminaron) y, cuando la terminal
dice cuál es su fondo, un zebra sutil; las teclas del pie son chips. El color
de acento es el violeta de litek8s.
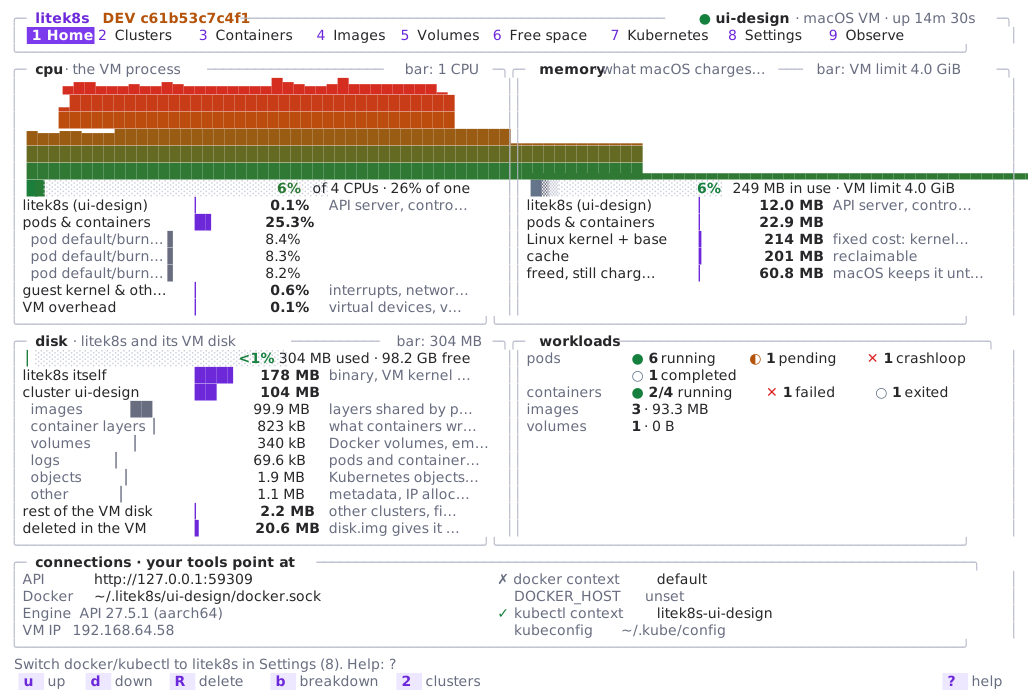
Antes y después, en la Mac con el mismo cluster (--cpus 4 --memory 4096, un deployment de 3 réplicas, uno que quema CPU, un pod en crash loop,
uno pendiente, un job terminado, un proyecto de compose), en una terminal
oscura:
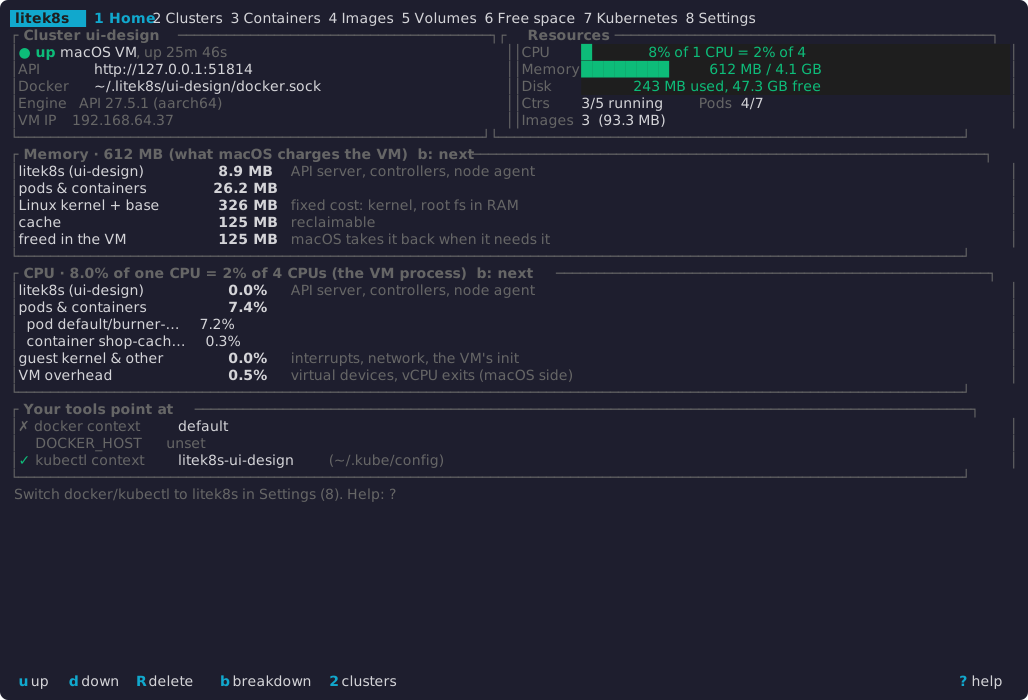
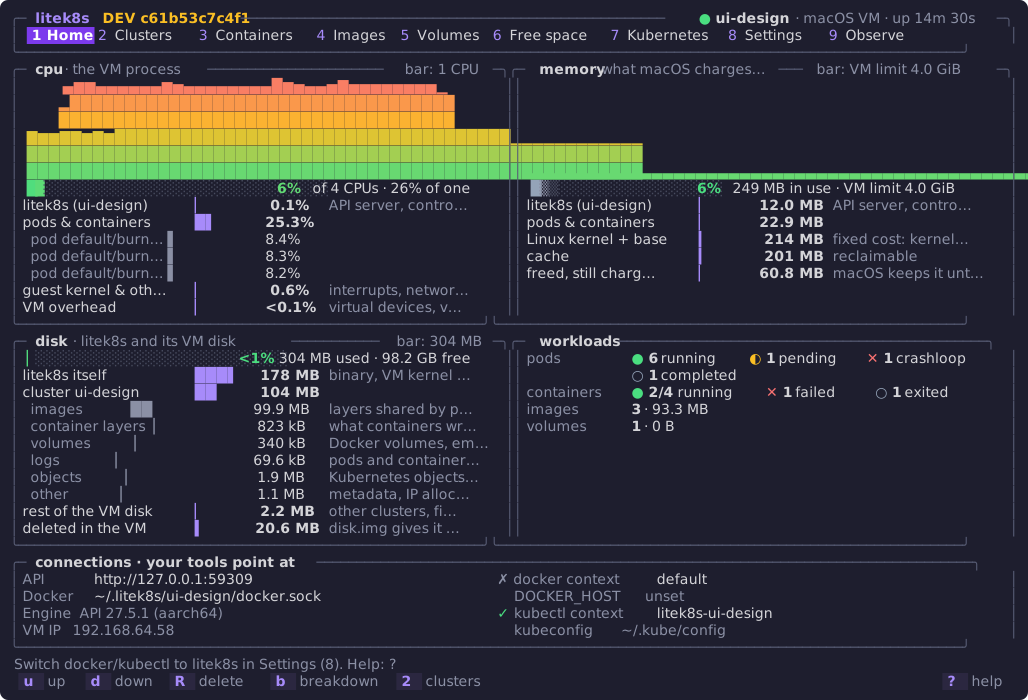
Lo mismo en una terminal clara, y la vista Kubernetes (oscura, con las filas zebra que permite el fondo reportado por la terminal):
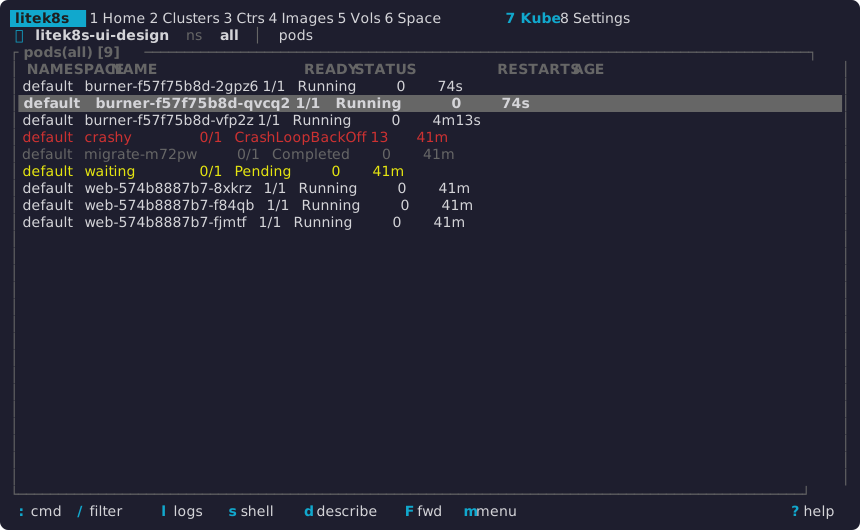
Como texto, en 80x24, antes:
 litek8s  1 Home 2 Clusters 3 Ctrs 4 Images 5 Vols 6 Space 7 Kube 8 Settings┌ Cluster ui-design ───────────────────┐┌ Resources ───────────────────────────┐│● up  macOS VM, up 48m 12s            ││CPU    ██  24% of 1 CPU = 6% of 4     ││API      http://127.0.0.1:51814       ││Memory █████   644 MB / 4.1 GB        ││Docker   …tek8s/ui-design/docker.sock ││Disk      252 MB used, 44.4 GB free   ││Engine   API 27.5.1 (aarch64)         ││Ctrs   3/5 running   Pods 6/9         ││VM IP    192.168.64.37                ││Images 3  (93.3 MB)                   │└──────────────────────────────────────┘└──────────────────────────────────────┘┌ Memory · 644 MB (what macOS charges the VM)  b: next ────────────────────────┐│litek8s (ui-design)     11.3 MB   API server, controllers, node agent         ││pods & containers       26.5 MB                                               ││Linux kernel + base      331 MB   fixed cost: kernel, root fs in RAM          ││cache                    130 MB   reclaimable                                 ││freed in the VM          146 MB   macOS takes it back when it needs it        │└──────────────────────────────────────────────────────────────────────────────┘┌ Your tools point at ─────────────────────────────────────────────────────────┐│✗ docker context   default                                                    ││  DOCKER_HOST      unset                                                      ││✓ kubectl context  litek8s-ui-design  (~/.kube/config)                        │└──────────────────────────────────────────────────────────────────────────────┘ Switch docker/kubectl to litek8s in Settings (8). Help: ?
 u up  d down  R delete  b breakdown  2 clusters                         ? help
y después: una columna, el encabezado en una sola línea, los medidores del
cluster y los pods por estado, la API de Docker de este cluster en una caja
propia (sus contenedores, imágenes, volúmenes y lo que ocupan), el desglose que
elige b, y adónde apuntan las herramientas cuando hay espacio:
 litek8s DEV 1c5f21c16f3c · …  1 Home 2 3 4 5 6 7 8 9          ● dev · macOS VM╭─ ● dev · macOS VM · up 6m 18s ───────────────────────────────────── cluster ─╮│ cpu    ▎░░░░░░░░░░░░░░░░░░░░░░░░░░░░░   1% of 7 CPUs · 5% of one             ││ memory ███████████▒▒▒▒▒▒▒▒▒▒░░░░░░░░░  36% 1.5 GiB in use · VM limit 4.0 GiB ││ disk   ████████▍░░░░░░░░░░░░░░░░░░░░░  28% 6.0/80.0 GiB · Mac 16.7 GB free   ││ pods   ● 21 running                                                          │╰──────────────────────────────────────────────────────────────────────────────╯╭─ docker · ~/.litek8s/docker.sock ─────────── cpu 100.0% of one · mem 200 MB ─╮│ ● 2/2 running   images 25 · 4.6 GB   vols 1 · 983 MB                         │╰──────────────────────────────────────────────────────────────────────────────╯╭─ Memory · 3.2 GB (what macOS charges; VM ceiling 2.6/4.0 GiB)  b: next ──────╮│ litek8s (dev)        ▋             234 MB  API server, controllers, node ag… ││ pods                 ██▌           990 MB                                    ││ Docker containers    ▌             200 MB  Docker API containers, builds (n… ││ Linux kernel + base  ▉             342 MB  fixed cost: kernel, page tables   ││ cache                ██▎           880 MB  reclaimable                       ││ freed, still charged █▍            555 MB  macOS keeps it until the VM rest… │╰────────────────────────────────────────────────────── bar: VM limit 4.0 GiB ─╯ Switch docker/kubectl to litek8s in Settings (8). Help: ?
 u up  d down  R delete  b breakdown  c copy API  2 clusters            ?  help
Una terminal ancha y alta (aquí 120x40) recibe el encabezado en caja, la CPU y la memoria lado a lado con su historial (una columna por muestra, cada 2 s, durante todo el tiempo que Home haya estado en pantalla), el disco, y los pods y la caja de docker debajo de ellos:
╭─ litek8s DEV 1c5f21c16f3c ──────────────────────────────────────────────────────────── ● dev · macOS VM · up 6m 12s ─╮│ 1 Home 2 Clusters 3 Containers 4 Images 5 Volumes 6 Free space 7 Kubernetes 8 Settings 9 Observe │╰──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────╯╭─ cpu · the VM process ────────────────────── bar: 1 CPU ─╮╭─ memory · what macOS charges… ─── bar: VM limit 4.0 GiB ─╮│ ││ ││ ▂ ││ ▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁ ││ ▅▂▁▁▁▂▂▁▂▁▁▂▁▂▃█▂▁▁ ││ ███████████████████ ││ ▏░░░░░░░░░░░░░░░░░░░░░░░░░░░░ 1% of 7 CPUs · 4% of one ││ ██████▒▒▒▒▒▒░░░░░ 36% 1.5 GiB in use · VM limit 4.0 GiB ││ litek8s (dev) ▏ 0.2% API server, contro… ││ litek8s (dev) ▍ 234 MB API server, contro… ││ pods ▏ 1.8% ││ pods █▍ 993 MB ││ pod openbao/open… ▏ 0.4% ││ Docker containers ▎ 200 MB Docker API contain… ││ pod argocd/argoc… ▏ 0.4% ││ Linux kernel + base ▌ 340 MB fixed cost: kernel… ││ pod argocd/argoc… ▏ 0.3% ││ cache █▎ 880 MB reclaimable ││ Docker containers ██████ 100.0% Docker API contain… ││ freed, still charg… ▊ 554 MB macOS keeps it unt… ││ container burner ██████ 100.0% ││ ││ guest kernel & oth… ▏ 1.7% interrupts, networ… ││ ││ VM overhead ▏ 0.5% virtual devices, v… ││ │╰──────────────────────────────────────────────────────────╯╰──────────────────────────────────────────────────────────╯╭─ disk · litek8s and its VM disk ─────────── bar: 7.1 GB ─╮╭─ pods ───────────────────────────────────────────────────╮│ █████▎░░░░░░░░░░░░░ 28% 6.0/80.0 GiB · Mac 16.7 GB free ││ pods ● 21 running ││ litek8s itself ▏ 180 MB binary, VM kernel … │╰──────────────────────────────────────────────────────────╯│ cluster dev █████▍ 6.4 GB │╭─ docker · …cker.sock ─── cpu 100.0% of one · mem 200 MB ─╮│ images ████ 4.7 GB 1.3 GB reclaimable… ││ containers ● 2/2 running ││ container layers ▏ 1.4 MB what containers wr… ││ images 25 · 4.6 GB vols 1 · 983 MB ││ volumes █▌ 1.7 GB 982.5 MB reclaimab… ││ ││ logs ▏ 4.5 MB pods and container… ││ ││ builds ▏ 4.1 kB running builds, ca… ││ ││ objects ▏ 15.8 MB Kubernetes objects… ││ ││ other ▏ 1.6 MB metadata, IP alloc… ││ ││ rest of the VM disk ▏ 2.2 MB other clusters, fi… ││ ││ deleted in the VM ▍ 480 MB disk.img gives it … ││ │╰──────────────────────────────────────────────────────────╯╰──────────────────────────────────────────────────────────╯╭─ connections · your tools point at ──────────────────────────────────────────────────────────────────────────────────╮│ API http://127.0.0.1:58913 ✗ docker context orbstack ││ Docker ~/.litek8s/docker.sock DOCKER_HOST unset ││ Engine API 27.5.1 (aarch64) ✓ kubectl context litek8s-dev ││ VM IP 192.168.64.57 kubeconfig ~/.kube/config │╰──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────╯ Switch docker/kubectl to litek8s in Settings (8). Help: ? u up d down R delete b breakdown c copy API 2 clusters ? helpTerminales. Nada necesita una Nerd Font: solo caracteres de dibujo de cajas y de bloques y unos pocos símbolos comunes. La UI se adapta al arrancar:
| cómo se decide | qué cambia | |
|---|---|---|
| colores | NO_COLOR (no vacío): ninguno; COLORTERM=truecolor/24bit: 24 bits; un TERM con 256 (y tmux, kitty, alacritty, ghostty, wezterm): 256; si no, 16 |
256: cada color, el más cercano de la paleta de xterm; 16: los colores con nombre de la propia terminal (hechos para su fondo), la selección en video inverso; ninguno: solo negrita, atenuado, subrayado e inverso |
| fondo | background: en ui.yaml; si no, se le pregunta una vez a la terminal con OSC 11 (ver abajo); si no, COLORFGBG |
oscuro: tonos más claros; claro: más oscuros y selecciones pálidas; desconocido: tonos medios que se leen en ambos, y una selección fuerte con su propio color de texto; filas zebra solo cuando se conoce el color exacto |
| caracteres | ascii: true en ui.yaml, LITEK8S_UI_ASCII=1, o TERM=linux/vt100/vt220 |
esquinas de caja +, líneas - ` |
| tema | theme: en ui.yaml |
default; high-contrast: los colores brillantes de la terminal, fallos en negrita, sin texto ni bordes grises; mono: ningún color |
theme: default # high-contrast, monobackground: auto # dark, light: no le pregunta a la terminalascii: false # true: ASCII para fuentes sin caracteres de cajas y bloquesSettings (8) muestra lo que se detectó (Look: default, 24-bit color, dark background).
Preguntar por el fondo no cuesta nada que pueda fallar: antes de que arranque
el lector de entrada, la UI escribe una consulta OSC 11 seguida de una consulta
DA1 y lee las respuestas directamente de la terminal. Las terminales responden
en orden y prácticamente todas responden DA1, así que la espera termina con esa
respuesta: 0.1 ms en tmux en la Mac, 11 ms por SSH a omarchy (un viaje de ida y
vuelta); una terminal que no responde ninguna cuesta como máximo 150 ms una
vez, y la UI arranca con los colores válidos para cualquiera de los dos fondos.
(La consulta de posición del cursor, que alguna vez hizo fallar el arranque en
terminales que nunca responden, sigue sin usarse.) Se omite cuando ui.yaml
define background, el tema es mono, o hay 16 colores o menos.
Costo. El historial es un anillo de 240 muestras (dos f32 cada una),
llenado por las muestras de 2 s de Home solo mientras Home está en pantalla,
así que no agrega ningún timer ni ningún wake-up; oculto, nada muestrea más
rápido que antes. En reposo 60 s por vista, main frente a este aspecto:
| Home | Containers | Kubernetes | |
|---|---|---|---|
macOS, 120x40, CPU (ps) |
0.07 % → 0.08 % | 0.00 % → 0.02 % | 0.00 % → 0.00 % |
Linux (omarchy), 80x24, CPU (/proc) |
0.12 % → 0.12 % | 0.02 % → 0.00 % | 0.00 % → 0.00 % |
| Linux, wake-ups (cambios de contexto) por minuto | 124 → 130 | 19 → 8 | 13 → 13 |
| Linux, 120x40, Home | 0.12 % → 0.12 %, 137 → 119 wake-ups |
El primer frame llega 1.0 ms → 1.2 ms después del arranque (Mac, tmux). El binario crece 70 KiB stripped en macOS arm64 (35 460 136 → 35 532 200 bytes; 42 798 032 → 42 889 088 tal como se compila) y 12 KiB en Linux x86_64 (41 294 312 → 41 306 696), sin ninguna dependencia nueva.
Pantallas
Sección titulada «Pantallas»Capturadas de sesiones reales en la VM de macOS y, por SSH, en el sandbox
rootless de Linux; las pruebas usaron rutas temporales y un segundo puerto de
API, que aquí se muestran como los tiene una instalación por defecto
(~/.litek8s, ~/.kube/config, 6443).
Home:
 litek8s DEV 1c5f21c16f3c · …  1 Home 2 3 4 5 6 7 8 9          ● dev · macOS VM╭─ ● dev · macOS VM · up 6m 18s ───────────────────────────────────── cluster ─╮│ cpu    ▎░░░░░░░░░░░░░░░░░░░░░░░░░░░░░   1% of 7 CPUs · 5% of one             ││ memory ███████████▒▒▒▒▒▒▒▒▒▒░░░░░░░░░  36% 1.5 GiB in use · VM limit 4.0 GiB ││ disk   ████████▍░░░░░░░░░░░░░░░░░░░░░  28% 6.0/80.0 GiB · Mac 16.7 GB free   ││ pods   ● 21 running                                                          │╰──────────────────────────────────────────────────────────────────────────────╯╭─ docker · ~/.litek8s/docker.sock ─────────── cpu 100.0% of one · mem 200 MB ─╮│ ● 2/2 running   images 25 · 4.6 GB   vols 1 · 983 MB                         │╰──────────────────────────────────────────────────────────────────────────────╯╭─ Memory · 3.2 GB (what macOS charges; VM ceiling 2.6/4.0 GiB)  b: next ──────╮│ litek8s (dev)        ▋             234 MB  API server, controllers, node ag… ││ pods                 ██▌           990 MB                                    ││ Docker containers    ▌             200 MB  Docker API containers, builds (n… ││ Linux kernel + base  ▉             342 MB  fixed cost: kernel, page tables   ││ cache                ██▎           880 MB  reclaimable                       ││ freed, still charged █▍            555 MB  macOS keeps it until the VM rest… │╰────────────────────────────────────────────────────── bar: VM limit 4.0 GiB ─╯ Switch docker/kubectl to litek8s in Settings (8). Help: ?
 u up  d down  R delete  b breakdown  c copy API  2 clusters            ?  help
El medidor de memoria es lo que ocupan los dueños del cluster (litek8s, pods,
otros clusters, el kernel y la base; no los contenedores de la API de Docker,
que muestra la caja de docker) frente al --memory de la VM, el límite del
sandbox o, si no lo hay, la RAM del host, como partes apiladas; a continuación
vienen la cache (▒, atenuada) y las páginas que el guest liberó pero que macOS
todavía cobra (▒, más oscuras), que no cuentan como en uso. Su porcentaje se
colorea según qué tan escaso esté realmente el guest (su MemAvailable, más lo
que devolvería el balloon de la VM), no según qué tan lleno se ve el medidor:
la huella de la VM en macOS también conserva páginas que el guest liberó hace
mucho y puede superar el tamaño de la VM mientras el guest tiene gigabytes
disponibles. Se pone rojo, y dice short, solo cuando queda menos de más o
menos una décima parte.
Debajo de los medidores, Home explica sus cifras: de qué están hechas la
memoria, la CPU y el disco, como barras en línea. Cada barra es el valor de su
fila frente a una escala que nombra la caja (bar: 1 CPU, bar: VM limit 4.0 GiB, bar: 305 MB, arriba a la derecha de la caja o, cuando el título
necesita el espacio, abajo a la derecha), nunca frente a la fila más grande,
así que la barra y el número coinciden: una fila al 0.1 % de una CPU es una
astilla, una al 50 % media barra, una que pasa de una CPU entera una barra
completa (su número dice cuánto se pasa); un valor que redondea a nada imprime
<0.1% con a lo sumo una línea finísima, y el cero no tiene barra. Una caja a
la vez en 80x24 (b muestra la siguiente; una terminal alta muestra las tres).
Memoria, en la Mac (una VM recién creada corriendo el corpus de compatibilidad):
╭─ Memory · 589 MB (what macOS charges; VM ceiling 1.0/4.0 GiB) b: next ──────╮│ litek8s (dev) ▏ 11.9 MB API server, controllers, node ag… ││ pods & containers ▏ 635 kB ││ Linux kernel + base ▌ 214 MB fixed cost: kernel, page tables ││ cache ▊ 296 MB reclaimable ││ freed, still charged ▏ 65.8 MB macOS keeps it until the VM rest… │╰────────────────────────────────────────────────────── bar: VM limit 4.0 GiB ─╯| línea | qué es | de dónde sale |
|---|---|---|
| litek8s (cluster) | los procesos propios del cluster mostrado (API server, controllers, node agent, shims de crun) en todos sus nodos | los cgroups de sus cells: el uso menos las páginas de archivo, menos lo de los pods |
| pods | sus pods | los cgroups pod* bajo cada nodo |
| Docker containers | los contenedores y builds de imágenes de la API de Docker del cluster: corren en su nodo, pero no son del cluster (el medidor del cluster los deja fuera, la caja de docker los muestra) | los cgroups docker/*, build/* bajo cada nodo |
| other clusters | lo mismo para cada uno de los demás clusters en ejecución, en conjunto | sus cells |
| Linux kernel + base (macOS) | lo que cuesta la VM antes de que corra nada: la memoria que el kernel reserva al arrancar (su imagen y las estructuras de páginas, ~3.5 % del tamaño de la VM), su slab no recuperable, stacks y tablas de páginas, y tmpfs (el initramfs de un guest más viejo, el sistema de archivos raíz guardado en RAM); también el propio init de la VM, el cell manager y el cliente DHCP | el tamaño de la VM menos MemTotal y el balloon, /proc/meminfo |
| sandbox (Linux) | el supervisor, pasta y el cell manager | el cgroup del sandbox menos el de los clusters |
| cache | páginas de archivo: imágenes, logs, el binario; el kernel las descarta bajo presión | /proc/meminfo (VM) o las páginas file del sandbox |
| freed, still charged (macOS) | páginas que el guest usó alguna vez y liberó (o entregó al balloon desde entonces): Virtualization.framework se las sigue cobrando a la VM hasta que se detiene, por mucha memoria que necesite macOS (las comprime o las manda a swap como cualquier otra); el guest las reutiliza antes de tocar más. Reiniciar la VM (dev down, dev up) las devuelve |
la huella menos lo que usa el guest |
El título también dice cuánta de su memoria puede usar el guest ahora, cuando eso es menos que toda: el techo de la VM, que crece según la demanda y se reduce cuando el guest está inactivo (dev.md); lo que está por encima nunca se tocó, y macOS no cobra nada por ello.
La cifra principal es lo que macOS le cobra al proceso de la VM (su huella
física, lo que muestra el Monitor de Actividad) o, en Linux, el cgroup del
sandbox. Los números del guest vienen de sus cgroups y de /proc/meminfo a
través del canal de control de la VM; un litek8s remoto (--context) responde
GET /litek8s/v1/memory en su API server con el desglose de su nodo (litek8s,
pods y contenedores, cache) y su meminfo, que Home muestra en su lugar. Se
muestrea junto con el resto de Home: cada 2 s mientras Home está en pantalla, y
no en otro caso.
CPU, entre las dos últimas muestras (2 s), en % de una CPU, en la Mac con tres pods ocupados:
╭─ CPU · 26.0% of one CPU = 6% of 4 CPUs (the VM process) b: next ────────────╮│ litek8s (ui-design) ▏ 0.1% API server, controllers, node… ││ pods & containers ██▌ 25.4% ││ pod default/burner-f5… ▉ 8.4% ││ pod default/burner-f5… ▉ 8.3% ││ pod default/burner-f5… ▉ 8.3% ││ guest kernel & other ▏ 0.5% interrupts, network, the VM's… ││ VM overhead ▏ <0.1% virtual devices, vCPU exits (… │╰───────────────────────────────────────────────────────────────── bar: 1 CPU ─╯| línea | qué es | de dónde sale |
|---|---|---|
| litek8s (cluster) | los procesos propios del cluster mostrado en todos sus nodos | el cpu.stat de sus cells menos el de sus pods |
| pods, y el top 3 | todos los pods del cluster, los más ocupados por nombre | los cgroups pod* (usage_usec) |
| Docker containers, y el top 3 | los contenedores y builds de la API de Docker del cluster | los cgroups docker/*, build/* |
| other clusters | el resto de los clusters en conjunto | sus cells |
| guest kernel & other (macOS) | tiempo ocupado que el guest no le atribuye a un cluster: interrupciones, el stack de red, el init de la VM | el /proc/stat del guest menos los clusters |
| VM overhead (macOS) | lo que el proceso de la VM ejecutó más allá del tiempo ocupado del guest: dispositivos virtuales, salidas de vCPU | el tiempo de CPU del proceso de la VM (macOS) menos el /proc/stat del guest |
| sandbox (Linux) | el supervisor, pasta y el cell manager | el cgroup del sandbox menos el de los clusters |
La cifra del título es el tiempo de CPU del proceso de la VM tal como lo cuenta
macOS, o el cgroup del sandbox. El medidor de cpu del cluster es eso menos la
parte de los contenedores de Docker, y su medidor de memoria lo que está en uso
menos lo de ellos: los contenedores de la API de Docker corren en la misma VM o
sandbox, pero no son del cluster, así que Home los pone en la caja de docker
debajo del cluster (docker · ~/.litek8s/docker.sock ── cpu 6.0% of one · mem 1.1 GB, luego los contenedores por estado, las imágenes y los volúmenes).
Ambos medidores van frente a --cpus y --memory de la VM (o los límites del
sandbox, si no, las CPUs de la máquina), nunca frente al /info del engine de
Docker: con --docker-host las vistas de Docker muestran otro engine, y la
caja de docker da entonces el tamaño propio de ese engine (its engine: 16 CPUs · 34.4 GB) en lugar del del cluster.
Disco, en la Mac con los workloads de arriba (el recorrido tiene como máximo un minuto de antigüedad):
╭─ Disk · 305 MB (litek8s and its VM disk) b: next ───────────── bar: 305 MB ─╮│ litek8s itself ██████▍ 178 MB binary, VM kernel and root fs ││ cluster ui-design ███▊ 104 MB ││ images ███▋ 99.9 MB layers shared by pods, Docker, bu… ││ container layers ▏ 823 kB what containers wrote ││ volumes ▏ 340 kB Docker volumes, emptyDirs, PVs ││ logs ▏ 69.6 kB pods and containers, 10 MiB each ││ objects ▏ 1.9 MB Kubernetes objects, keys ││ other ▏ 1.1 MB metadata, IP allocations ││ rest of the VM disk ▏ 2.2 MB other clusters, filesystem ││ deleted in the VM ▊ 20.9 MB disk.img gives it back within a m… │╰──────────────────────────────────────────────────────────────────────────────╯| línea | qué es |
|---|---|
| litek8s itself | el binario litek8s; en macOS también el kernel de la VM, la imagen raíz y el initrd, y la copia firmada del binario desde la que corre la VM |
| images | las capas desempaquetadas de cada imagen y del build cache: un store direccionado por contenido por nodo, compartido por pods, Docker y builds, cada capa una sola vez |
| container layers | lo que escribieron los contenedores de pods y los contenedores de Docker (sus directorios upper de overlay) |
| volumes | volúmenes de Docker (con nombre y anónimos), emptyDirs de pods, PVs locales, archivos de ConfigMap y Secret |
| logs | logs de pods y contenedores (10 MiB y un archivo rotado cada uno) |
| builds | builds en curso y directorios RUN --mount=type=cache |
| objects | objetos de Kubernetes (el write-ahead log, compactado) y las llaves del cluster |
| other nodes | los workers de un cluster multinodo (cada uno con su propio store de imágenes) |
| other | metadatos, asignaciones de IP, staging |
| rest of the VM disk (macOS) | los demás clusters y los bloques propios del sistema de archivos |
| deleted in the VM (macOS) | bloques que el guest liberó y que disk.img todavía conserva: el guest hace trim de su disco una vez que lleva 30 s tranquilo (como máximo una vez por minuto), y Virtualization.framework perfora los bloques recortados de la imagen sparse, así que esto vuelve a casi cero poco después de un prune |
Donde las imágenes, las capas de contenedores y los volúmenes tienen algo que
recuperar, la nota dice cuánto y apunta a la vista Free space (6), que lo
libera: esas cantidades vienen del /system/df de la API de Docker (imágenes y
build cache sin usar, contenedores detenidos, volúmenes sin usar). Las
categorías vienen de GET /litek8s/v1/disk en el API server del cluster: un
recorrido del directorio de datos del nodo que cuenta los bloques asignados y
los hard links una sola vez, clasifica cada archivo según dónde está (así que
las partes suman el total), y corre como máximo una vez por minuto, en segundo
plano (Home pregunta cada 30 s mientras está en pantalla). El LayersSize de
/system/df ahora cuenta cada capa una sola vez y las imágenes reportan su
SharedSize, como lo hace Docker.
Frente a un litek8s remoto (--context), las tres cajas muestran el nodo de su
API server: GET /litek8s/v1/memory, /litek8s/v1/cpu (contadores
acumulativos, dos muestras dan los porcentajes) y /litek8s/v1/disk, y el
/proc/stat de su máquina para el resto de su CPU. La memoria es la de todo el
nodo, como la ve free: litek8s, pods y contenedores, el sistema operativo
(kernel, su slab y tablas de páginas, servicios como sshd o tailscaled) y la
page cache, sobre la RAM del nodo; los gráficos se llenan como en un cluster
local. u, d y R actúan sobre los clusters de desarrollo de esta máquina,
así que Home los rechaza para uno remoto, y las vistas de Docker (3 a 6), que
leen la API de Docker del cluster de desarrollo de esta máquina a menos que
--docker-host indique otra, lo dicen en lugar de fallar.
Frente a un cluster que no es litek8s (k3s, kubeadm, uno gestionado: su
/version no lleva +litek8s), esos endpoints no existen, así que Home lee
la API pública. La cabecera dice qué es (k3s v1.35.0+k3s1, RKE2, EKS,
GKE, si no Kubernetes). CPU y memoria son lo que muestra kubectl top nodes: el uso de cada nodo según metrics.k8s.io (los NodeMetrics de
metrics-server, pedidos cada 2 s mientras Home está en pantalla) frente a lo
que su objeto Node tiene asignable (listado cada 30 s); los medidores suman
el cluster o muestran el nodo elegido con n, y el gráfico de cada ámbito se
llena desde entonces. Los desgloses son por nodo: memoria, CPU y disco como
porcentaje de lo asignable de cada nodo (su sistema de archivos raíz para el
disco), en amarillo pasado el 80 % y en rojo pasado el 90 %, sin el prefijo
que comparten todos los nombres de nodo (…x7k2p). El disco sale del
/stats/summary de cada kubelet a través del proxy de nodos del API server
(get de nodes/proxy, cada 30 s); si RBAC lo rechaza, Home dice “not
available” y deja de preguntar. Sin metrics-server los medidores muestran lo
asignable y dicen metrics.k8s.io not served en lugar de esperar. La caja de
conexiones dice de dónde salen las cifras (ni Docker, ni motor, ni VM: esos
son de esta máquina). Home solo lee ahí; la vista de Kubernetes sigue en solo
lectura salvo con W o writableContexts.
Debajo de los medidores de CPU y memoria, una línea dice lo que los pods
reservan (sus requests) y pueden usar (sus límites) de los nodos
mostrados, frente a los recursos asignables de esos nodos, de la forma en que
los cuentan el scheduler y kubectl describe node (los requests de un pod son
el mayor entre la suma de sus contenedores y su init container más grande; los
pods Succeeded y Failed no reservan nada), y cuántos pods no tienen límite:
reserved 10.6 GiB 35% · limits 28.1 GiB 93% · 14 pods without a limitEl medidor es lo que se usa ahora; esta línea es lo que el scheduler ha
prometido. Límites por encima del 100% (en rojo) significan que los pods, en
conjunto, podrían pedir más de lo que tienen los nodos. Con varios nodos, n
pasa de todo el cluster a cada nodo, y la línea lo sigue. En la vista
Kubernetes, la tabla de nodos (:nodes) muestra lo mismo por nodo: CPU REQ,
CPU LIM, MEM REQ, MEM LIM, cada uno con su porción de lo asignable del
nodo, junto a CPU y MEM (uso, de metrics.k8s.io).
Después de u sobre un cluster detenido, la salida de litek8s dev up aparece
debajo (aquí en Linux, por SSH):
╭─ output ─────────────────────────────────────────────────────────────────────╮│$ litek8s dev up ││litek8s-dev ready in 0.10s (rootless, http://127.0.0.1:6443, kubectl context │╰──────────────────────────────────────────────────────────────────────────────╯En Linux el modo es rootless sandbox, y los medidores van frente a la máquina
(aquí las 16 CPUs y 31.3 GiB de omarchy, por SSH, en reposo) o, con un límite de
CPU o memoria definido en Settings, frente al límite; las cifras demasiado
pequeñas para redondear a algo se leen <1% y <0.1%:
litek8s 1 Home 2 Clust 3 Ctrs 4 Imgs 5 Vols 6 Space 7 Kube 8 Set 9 Obs ● dev╭─ ● dev · rootless sandbox · up 16h 18m ────────────────────────── resources ─╮│ cpu ░░░░░░░░░░░░░░░░░░░░░░░░░░░░░ <1% of 16 CPUs · <1% of one ││ memory ▎░░░░░░░░░░░░░░░░░░░░░░░░░░░░ <1% 44.6 MB in use · host RAM 31.3 GiB ││ disk ░░░░░░░░░░░░░░░░░░░░░░░░░░░░░ <1% 191 MB used · 1.5 TB free ││ pods ● 0 running ││ ctrs ● 0/1 running ✕ 1 failed images 3 · 122 MB │╰──────────────────────────────────────────────────────────────────────────────╯╭─ CPU · 0.1% of one CPU = <1% of 16 CPUs (the sandbox) b: next ──────────────╮│ litek8s (dev) ▏ <0.1% API server, controllers, node agent ││ pods & containers 0.0% ││ sandbox ▏ <0.1% supervisor, pasta, cell manager │╰───────────────────────────────────────────────────────────────── bar: 1 CPU ─╯Containers, con un proyecto de compose (un worker que terminó con 3) y una confirmación:
litek8s 1 Home 2 Clust 3 Ctrs 4 Imgs 5 Vols 6 Space 7 Kube 8 Set 9 Obs╭─ Containers ─────────────────────────────────────────────────── 3/5 running ─╮│ NAME STATE IMAGE PORTS ││ api ● running nginx:1.27-alpine 18080->80/tcp ││ scratch ○ exited busybox:1.36 ││▌▾ shop ◐ 2/3 up compose project ││ cache ● running redis:7-alpine 6379/tcp ││ web ● running nginx:1.27-alpine 80/tcp ││ worker ╭─ ⚠ Stop project shop? ────────────────────╮ ││ │ shop-cache-1 (redis:7-alpine, running) │ ││ │ shop-web-1 (nginx:1.27-alpine, running) │ ││ │ shop-worker-1 (busybox:1.36, exited) │ ││ │ │ ││ │ y yes n/esc no │ ││ ╰───────────────────────────────────────────╯ │╰──────────────────────────────────────────────────────────────────────────────╯ l logs s shell u start x stop r restart d remove / filter ? helpContenedores y presupuestos
Sección titulada «Contenedores y presupuestos»En litek8s un proyecto de compose puede tener un presupuesto de recursos
(docker.md). Su fila
muestra entonces la memoria del proyecto frente al presupuesto (el medidor que
usa Home), las CPUs que usa de su presupuesto, y cuántos procesos se llevó el
OOM killer; un contenedor que detuvo el OOM killer dice OOMKilled en lugar de
exited, y el kill aparece en la línea de estado en el momento en que ocurre
(shop-worker-1 was OOM-killed: compose project shop hit its 256Mi budget):
╭─ Containers ─────────────────────────────────────────────────── 2/4 running ─╮│ NAME STATE IMAGE PORTS ││▌scratch ○ exited nginx:1.27 ││ ▾ shop ◐ 2/3 up ████▌░ 75% 192Mi/256Mi cpu 0.5/2 ✗ 1 OOM││ web ● running nginx:1.27 8080->80/tcp ││ db ● running nginx:1.27 8080->80/tcp ││ worker ✕ OOMKilled nginx:1.27 │╰──────────────────────────────────────────────────────────────────────────────╯Un proyecto sin presupuesto muestra su memoria (mem 115Mi · no budget). El
uso se muestrea cada 2 s mientras la vista está en pantalla (una petición a
/litek8s/v1/docker/projects) y nunca en otro caso; los demás engines de
Docker no tienen presupuestos y no se les vuelve a preguntar.
l sigue el log de un contenedor (o de un pod); ↑/PgUp retroceden y dejan
de seguirlo, G o f lo siguen de nuevo, w ajusta las líneas largas. Las
secuencias de escape se eliminan, así que los logs con colores no pueden pintar
encima de la UI:
╭─ logs: api ─────────────────────────────────────────────────────── ● follow ─╮│ 2026/10/20 05:02:04 [notice] 1#1: OS: Linux 6.12.113-0-virt ││ 2026/10/20 05:02:04 [notice] 1#1: getrlimit(RLIMIT_NOFILE): 4096:4096 ││ 2026/10/20 05:02:04 [notice] 1#1: start worker processes ││ 2026/10/20 05:02:04 [notice] 1#1: start worker process 25 ││ 2026/10/20 05:02:04 [notice] 1#1: start worker process 26 ││ 2026/10/20 05:02:04 [notice] 1#1: start worker process 27 ││ 2026/10/20 05:02:04 [notice] 1#1: start worker process 28 │╰──────────────────────────────────────────────────────────────────────────────╯ esc back f follow w wrap ↑↓ scroll g/G top/end ? helps suspende la UI y abre una shell en el contenedor (bash si tiene, si no sh)
con el tamaño de tu terminal, siguiendo los cambios de tamaño; sal de la shell
para volver. Es docker exec -it sobre la API de Docker, así que no necesita
la CLI de docker.
Images:
litek8s 1 Home 2 Clust 3 Ctrs 4 Imgs 5 Vols 6 Space 7 Kube 8 Set 9 Obs╭─ Images ─────────────────────────────────────────────────────── 3 · 93.3 MB ─╮│ IMAGE SIZE AGE USED BY ││▌busybox:1.36 4.1 MB 1250d scratch +7 ││ nginx:1.27-alpine 49.7 MB 551d api +4 ││ redis:7-alpine 39.5 MB 32d shop-cache-1 │╰──────────────────────────────────────────────────────────────────────────────╯ d remove / filter 6 free space ? helpFree space, y lo que pregunta p antes de liberar nada:
litek8s 1 Home 2 Clust 3 Ctrs 4 Imgs 5 Vols 6 Space 7 Kube 8 Set 9 Obs╭─ Reclaimable space ───────────────────────────────────────────── 0 B in all ─╮│ WHAT ITEMS SIZE ││▌[✓] Stopped containers 2 0 B ││ [✓] Dangling images (untagged, unused) 0 0 B ││ [✓] Build cache 0 0 B ││ [ ] Unused images (no container or pod) 0 0 B ││ [ ] Unused volumes (data is lost) 1 0 B │╰────────────────╭─ ⚠ Free space? ───────────────────────────╮─────────────────╯ Selected 0 B │ Stopped containers: 2 (0 B) │ │ About 0 B freed. This cannot be undone. │ litek8s data 31│ │s.litek8s/dev disk free 47.│ y yes n/esc no │ ╰───────────────────────────────────────────╯ Docker and Kubernetes share one image store: images no container or pod uses are unused (pods pull them again when needed). Volumes are never selected by default: they hold data. space select p free selected ? helpKubernetes, todos los namespaces (0); ctrl-z dejaría solo los que están en
crash y los pendientes:
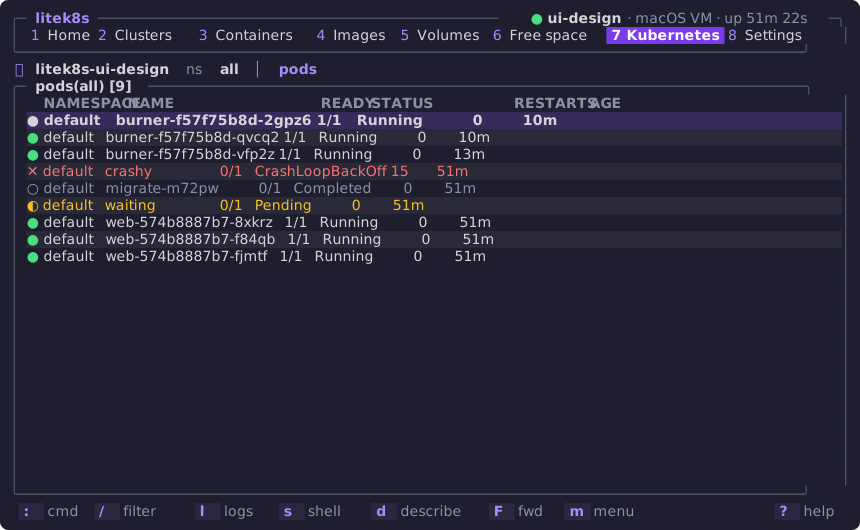
litek8s 1 Home 2 Clust 3 Ctrs 4 Imgs 5 Vols 6 Space 7 Kube 8 Set 9 Obs ⎈ litek8s-ui-design ns all │ pods╭─ pods(all) [9] ──────────────────────────────────────────────────────────────╮│ NAMESPACE NAME READY STATUS RESTARTS AGE ││ ● default burner-f57f75b8d-2gpz6 1/1 Running 0 8m40s ││ ● default burner-f57f75b8d-qvcq2 1/1 Running 0 8m40s ││ ● default burner-f57f75b8d-vfp2z 1/1 Running 0 11m ││ ✕ default crashy 0/1 CrashLoopBackOff 14 49m ││ ○ default migrate-m72pw 0/1 Completed 0 49m ││ ◐ default waiting 0/1 Pending 0 49m ││ ● default web-574b8887b7-8xkrz 1/1 Running 0 49m ││ ● default web-574b8887b7-f84qb 1/1 Running 0 49m ││ ● default web-574b8887b7-fjmtf 1/1 Running 0 49m │╰──────────────────────────────────────────────────────────────────────────────╯ : cmd / filter l logs s shell d describe F fwd m menu ? helpMás sobre esto en Kubernetes.
Settings de un cluster arrancado con --cpus 4 mientras el archivo no
especifica ninguna (así que su valor por defecto, 7, requeriría un reinicio), y
lo que la UI detectó sobre la terminal:
╭─ Settings ───────────────────────────────────────────────────────────────────╮│ SETTING VALUE ││▌VM CPUs 7 (default) ││ VM memory (MiB) 4096 (default) ││ Shared directories $HOME (default) ││ API port (dev) 6443 (default) ││ Published ports on localhost only ││ docker context default (enter: use litek8s) ││ kubectl context litek8s-ui-design ✓ (enter: switch back) ││ Config file ~/.litek8s/config.yaml (enter: $EDITOR) │╰──────────────────────────────────────────────────────────────────────────────╯ ⟳ Restart needed for CPUs: Home (1), d then u. CPUs, memory and shares size the macOS VM. Settings apply on the next `litek8s dev up` (its flags win). Look: default, 24-bit color, background unknown (ui.yaml) enter edit del default space toggle ? helpClusters
Sección titulada «Clusters»litek8s dev corre tantos clusters como quieras en una VM o sandbox
(dev.md); la vista 2 los lista, con el tamaño de
la VM o del sandbox y lo que usa, y los demás contextos de tu kubeconfig (un
cluster en casa, uno en la nube): enter sobre uno lo muestra en la vista
Kubernetes, en solo lectura a menos que lo
permitas, y showOtherContexts: false en ui.yaml los deja fuera
de la lista. En la Mac, con un cluster de 3 nodos y uno detenido:
 litek8s 1 Home  2 Clust 3 Ctrs 4 Imgs 5 Vols 6 Space 7 Kube 8 Set 9 Obs  ● dev╭─ Local clusters ──────────────── shared VM: 4 CPUs, 4.3 GB max, 412 MB used ─╮│ NAME           STATE       API              NODES MEMORY    AGE  CONTEXT     ││▌› dev          ● up        127.0.0.1:6443   1     27.2 MB   8m   litek8s-dev ││   ci           ● up        127.0.0.1:61325  3     5.6 MB    2m   litek8s-ci  ││   old          ○ down      -                1     -         3d   litek8s-old │╰──────────────────────────────────────────────────────────────────────────────╯╭─ Other kubeconfig contexts ── read-only by default · enter: Kubernetes view ─╮│   home                          https://192.168.1.10:6443                    │╰──────────────────────────────────────────────────────────────────────────────╯ All clusters share one VM (its CPUs and memory: Settings).
  n  new   u  up   d  down   D  delete   t  tree   enter  use         ?  help
› marca el cluster que muestran las demás vistas; ● up, ◐ arrancando o
deteniéndose, ○ down. MEMORY es la del propio cluster: los procesos y pods de
sus nodos, contados de la forma en que docker stats cuenta un contenedor (el
binario y el kernel de la VM son compartidos y no están incluidos); la cifra
del título es toda la VM (o el sandbox). NODES muestra 2/3 mientras un nodo
no está Ready.
n pide un nombre y una cantidad de nodos, y dice qué comparte el cluster:
╭─ New cluster ────────────────────────────────────────────────────╮ │ › Name ci2█ │ │ Nodes 1 │ │ │ │ Runs in the shared VM: 4 CPUs, 4096 MiB for all clusters. │ │ Context litek8s-ci2, socket ~/.litek8s/ci2/docker.sock │ │ Nodes after the first are workers joined like real nodes. │ │ │ │ tab next field enter create esc cancel │ ╰──────────────────────────────────────────────────────────────────╯y corre litek8s dev up --name ci2 --nodes 3 --no-switch (el contexto actual
de kubectl se queda como está), con su salida debajo de la lista. D dice qué
se va antes de que se vaya (aquí en Linux):
╭─ Delete cluster t1? ───────────────────────────────────────────────────────╮ │Stops it and DELETES all of its data: │ │Kubernetes objects, pods, Docker containers, images, volumes │ │and the build cache, in ~/.local/share/litek8s/dev/clusters/t1/data. │ │The kubectl context litek8s-t1 is removed. This cannot be undone. │ │ │ │ y yes n/esc no │ ╰────────────────────────────────────────────────────────────────────────────╯enter sobre un cluster local lo muestra en todas partes (Home, Containers,
Images, Volumes, Free space y Kubernetes siguen su socket de Docker y su API) y
luego pregunta si kubectl y docker también deberían apuntar a él
(current-context y el contexto de docker litek8s-<name>); la UI lo recuerda
para la próxima vez. enter sobre otro contexto muestra ese contexto solo en
la vista Kubernetes (ahí no hay nada que arrancar ni detener); enter sobre un
cluster local vuelve.
Mientras un cluster o su engine está caído, Home lo dice en lugar de contar
nada: pods –, ctrs – (engine not running), no 0/0 y 0 (0 B).
Observar
Sección titulada «Observar»La vista 9, sobre las métricas, los logs y las alertas integrados del cluster (observability.md):
litek8s 1 Home 2 Clust 3 Ctrs 4 Imgs 5 Vols 6 Space 7 Kube 8 Set 9 Obs ● dev╭─ Alerts ────────────────────────────────────────────── 3 firing · 0 pending ─╮│ ✕ firing NodeFilesystemAlmostFull 7m Node obs-smoke has 4.853% disk lef…││ ◐ firing KubePodCrashLooping 6m default/crasher-778d767f48-4zrkx (…││ ◐ firing KubePodRestartLoop 5m default/crasher-778d767f48-4zrkx (…│╰──────────────────────────────────────────────────────────────────────────────╯╭─ Pods by CPU ─────────────────────────── % of limit, r: of request · 30 min ─╮│ NAMESPACE POD CPU/LIMIT % MEM/LIMIT % CPU ││▌shop api-0 475m/500m 95% 243Mi/256Mi 95% ███████████││ shop worker-1 300m/100m r300% 100Mi/200Mi r 50% ▅▅▅▅▅▅▅▅▅▅▅││ shop cache-2 20m/— — 50Mi/— — ▁▁▁▁▁▁▁▁▁▁▁││ │╰──────────────────────────────────────────────────────────────────────────────╯ l logs L search logs s sort a/A ack n namespace ? help- Alertas primero:
✕disparada y crítica,◐disparada,○pendiente o reconocida (atenuada);areconoce las alertas del pod seleccionado,Atodas (cada una queda silenciada hasta que se resuelve; pregunta antes). - Pods por CPU (cores,
m= millicores) o memoria (working set;salterna), los que más consumen primero. Cada cifra se muestra frente al límite del pod (used/limity la proporción, coloreada de verde a rojo), sumada sobre sus contenedores y sidecars; un pod con un contenedor sin límite no tiene ninguno. Sin límite, el request ocupa su lugar (rantes de la proporción; ahí pasar del 100 % está bien, el pod simplemente usa más de lo que reservó); sin ninguno de los dos,/—. Luego, una sparkline de los últimos 30 minutos (una celda cada ~2 minutos; un hueco donde no hubo muestra): la del recurso por el que se ordena en 80 columnas, las dos en terminales anchas.nrecorre los namespaces,/filtra. - Logs:
labre todos los logs del pod seleccionado de la última hora, siguiéndolos, incluidos los contenedores que se reiniciaron o ya no existen;Lpide una regex y busca en los logs de todos los pods (del namespace mostrado) de la última hora, y luego los sigue.
Lee /prometheus/api/v1/query_range (dos consultas) y /litek8s/v1/alerts
cada 10 s mientras la vista está en pantalla, y nada en otro caso; frente a un
API server con --no-observability lo dice.
Configuración: ~/.litek8s/config.yaml
Sección titulada «Configuración: ~/.litek8s/config.yaml»La vista Settings edita un archivo pequeño que lee litek8s dev up (sus flags
tienen prioridad sobre él); $LITEK8S_CONFIG lo cambia de lugar. Cada cambio se
valida antes de escribirse: CPUs entre 1 y las de la máquina, memoria entre
1024 MiB y su RAM, un disco de 16 a 4096 GiB, un puerto de 1024 o más,
directorios compartidos que existan, sean absolutos, no se superpongan y no
estén ya compartidos.
cpus: 4 # macOS: las CPUs de la VM (por defecto: la mitad de las de la Mac, como máximo 8) # Linux: un límite de CPU sobre todo lo que corre el cluster de desarrollo (por defecto: ninguno)memory: 4096 # MiB; macOS: el techo de la VM (por defecto 4096); Linux: un límite (por defecto: ninguno)disk: 64 # GiB, macOS: el disco de datos de la VM; un valor mayor lo agranda en el próximo arranque de la VM, nunca lo reduceshares: # macOS: directorios compartidos con la VM en la misma ruta (por defecto: $HOME; - /Users/me # /tmp y /var/folders siempre se comparten) - /Volumes/srcport: 6443 # el puerto del API server en localhostpublish: localhost # dónde escuchan los puertos publicados de contenedores y los NodePorts: # localhost (por defecto) o all (también otras máquinas de la red)docker: # API de Docker: presupuestos de proyectos de compose, valores por defecto de contenedores projects: {shop: {memory: 2Gi, cpus: 2}} default_project: {memory: 4Gi}El archivo se lee cuando arranca el cluster. El cluster registra con qué
arrancó, así que la vista Settings (y nada más) te dice qué cambios todavía
necesitan d y u en Home. “Config file” lo abre en $VISUAL/$EDITOR (vi
si no hay) y lo verifica cuando el editor termina; una sección docker:
modificada va de inmediato a la API de Docker del cluster en ejecución (sin
reinicio, ver docker.md).
Contextos: apuntar tus herramientas a litek8s
Sección titulada «Contextos: apuntar tus herramientas a litek8s»Home muestra, y Settings cambia:
- Contexto de docker. “use litek8s” crea (o actualiza) un contexto
litek8sparaunix://~/.litek8s/docker.sock(para otro cluster,litek8s-<name>para~/.litek8s/<name>/docker.sock) y lo hace el actual, condocker contextcuando la CLI está instalada y escribiendo el store de contextos de la CLI ($DOCKER_CONFIG/contexts,config.json) cuando no lo está. “switch back” vuelve al contexto que era el actual antes (defaultsi no se registró ninguno).DOCKER_HOST, cuando está definido en tu shell, tiene prioridad sobre cualquier contexto; Home lo dice. - Contexto de kubectl. “use litek8s-dev” hace actual el contexto del cluster
mostrado (
litek8s-<name>) (agregándolo si el cluster está corriendo); “switch back” restaura el contexto actual anterior. Nada más cambia en el kubeconfig.
Lo que era el actual antes se guarda en ~/.litek8s/ui-state.json.
Kubernetes: una UI de cluster
Sección titulada «Kubernetes: una UI de cluster»La vista 7 es una UI de cluster con el espíritu de k9s, para cualquier cluster: los clusters de desarrollo locales, y cada contexto de tu kubeconfig (k3s, kind, EKS, GKE, AKS, …). Sus teclas son las de k9s donde k9s tiene una, así que los hábitos de k9s funcionan; es más ligera (ver los números) y viene con litek8s.
litek8s ui --context prod -n payments # empezar en un contexto y namespaceo :ctx adentro para elegir uno. Las credenciales son las que lee kubectl:
$KUBECONFIG (todos sus archivos, combinados como los combina kubectl), tokens,
archivos de token, certificados de cliente, basic auth y exec plugins
(gke-gcloud-auth-plugin, aws eks get-token, kubelogin, …), que se ejecutan
cuando se necesita un token y otra vez cuando expira o el servidor lo rechaza.
Cada petición va al contexto que muestra la UI; :kubectl lo pasa como
--context, así que el contexto actual del kubeconfig nunca se usa por
accidente.
Clusters de solo lectura
Sección titulada «Clusters de solo lectura»Por defecto, solo los clusters propios de litek8s se pueden modificar desde la
UI. Cualquier otro contexto (un cluster en la nube, el de un colega) es de
solo lectura: puedes listar, hacer describe, leer YAML y logs, seguir el
árbol y hacer port-forward, pero los borrados, ediciones, applies, el escalado,
los rollout restart y undo, cordon y drain, ejecutar un CronJob, las shells, los
comandos de :kubectl que cambian cosas (cualquiera excepto get, describe,
logs, top, rollout status, …) y los plugins no marcados con
mutates: false se rechazan, con un mensaje que dice cómo permitirlo. El
encabezado muestra read-only para un contexto así.
W activa la escritura para el contexto mostrado: te pide que escribas el
nombre del contexto (como hace GitHub para las acciones peligrosas), y desde
entonces el encabezado muestra un WRITE · <context> en rojo. tab en ese
diálogo además lo guarda en writableContexts en ui.yaml; sin eso, el modo
escritura dura hasta que la UI termina. W otra vez vuelve a solo lectura de
inmediato (y saca el contexto de writableContexts si estaba ahí). W está
reservada: tus hotkeys no pueden usarla.
Un contexto cuenta como litek8s cuando es uno de los clusters de litek8s dev
(litek8s-<name>, lkdev-<name> con $LITEK8S_HOME, comprobado contra los
clusters en disco) o cuando su API server lo dice (/version reporta
v1.33.0+litek8s; se pregunta una vez por contexto). Para modificar otro
cluster desde aquí, inclúyelo en ui.yaml:
writableContexts: [staging, home]readOnly: true hace que todos los clusters sean de solo lectura, incluidos
los de litek8s; W entonces lo dice.
En otros clusters de Kubernetes
Sección titulada «En otros clusters de Kubernetes»La vista Kubernetes habla solo la API estándar, así que funciona igual en EKS,
GKE, AKS, Civo, k3s, kind o cualquier cluster conforme: descubrimiento
(agregado, si no por grupo), Tables del lado del servidor, list+watch,
describe, YAML, edición con un dry run en el servidor, logs, exec (WebSocket
v5/v4), port-forward (SPDY), el árbol y xray, :kubectl. Las credenciales
vienen del kubeconfig igual que las de kubectl (exec plugins, tokens,
certificados de cliente, tls-server-name); nada suplanta a nadie. Qué es
propio de litek8s, y qué ves en otros lados:
| en litek8s | en otro cluster | |
|---|---|---|
| cambios (delete, edit, scale, shells, …) | permitidos | solo lectura hasta W o writableContexts |
| columnas CPU y MEM | de metrics.k8s.io cuando se sirve |
lo mismo: se muestran cuando el cluster tiene metrics-server, si no, no aparecen |
| Observe (9): historial de CPU/memoria de pods, alertas, búsqueda en logs | las métricas, alertas y el store de logs integrados del API server | no está: la vista dice que el cluster no es litek8s (logs: l sobre un pod o workload) |
Home (1) con --context: memoria, CPU y disco del nodo |
los endpoints de nodo de litek8s | lo asignable de los Nodes, metrics.k8s.io y las estadísticas de los kubelets si se permiten (Pantallas) |
| Vistas de Docker (3-6) | el socket de Docker del cluster | lo que sea a lo que apunte --docker-host, independientemente del contexto |
| Services → pods en el árbol | de la columna Selector de la Table del Service | lo mismo (la columna wide de kubectl; servidores más viejos: se leen como objetos) |
Modo comando (:)
Sección titulada «Modo comando (:)»| comando | qué muestra o hace |
|---|---|
:pods, :po, :deploy, :dp, :svc, :ing, :no, :ns, :ev, :crd, :cm, :sec, :pvc, … |
ese tipo de recurso: cualquier tipo que sirva el cluster, incluidos los custom resources y las APIs agregadas, por plural, singular, nombre corto, kind o plural.group (:certificates.cert-manager.io, :cert) |
:pods kube-system, :pods -n kube-system, :deploy -A |
en un namespace, o en todos |
:pods -l app=web,tier!=db, :pods -f status.phase=Running, :pods /nginx |
con un label selector, un field selector (enviado al servidor), un filtro |
:ctx / :ctx prod |
elegir un contexto / cambiar a uno (las vistas se reconectan) |
:ns / :ns web |
los namespaces / cambiar de namespace |
:tree, :tree shop, :tree -A --all |
el cluster como lo dibuja litek8s tree, en vivo (abajo); --all agrega los ReplicaSets viejos |
:xray deploy [ns] |
árboles de owners: deploy → ReplicaSets → pods → contenedores (también sts, ds, rs, job, cronjob → jobs → pods, svc → sus pods, node → sus pods) |
:kubectl get events -A, :!top pods, ! |
kubectl en el contexto y namespace de la UI; su salida en un pager (exec -it, edit, attach reciben la terminal) |
:pf |
los port-forwards en ejecución |
:aliases |
todos los tipos de recurso, para elegir uno |
:help, :q |
las teclas; salir |
tab (o →) completa nombres de recursos, comandos, namespaces después de
-n o :ns, contextos después de :ctx; el primer candidato aparece en gris
después del cursor. ↑/↓ recorren el historial (guardado en
~/.litek8s/ui-history). Tus propios alias vienen de ui.yaml.
Las columnas son las del servidor: la misma Table que imprime kubectl
(incluidas las printer columns de los custom resources), ctrl-w agrega las
anchas (-o wide). Las antigüedades se calculan a partir del momento de
creación, así que avanzan. Las filas se colorean según su salud: los pods por
su estado y readiness, los workloads por sus conteos de listos, los nodos por
sus condiciones, cualquier cosa con una columna Status por sus palabras.
Filtros (/)
Sección titulada «Filtros (/)»La lista se reduce a medida que escribes; tab cambia el modo:
| filtro | conserva |
|---|---|
web |
las filas cuyo nombre o alguna celda lo contiene (substring, sin distinguir mayúsculas) |
^web-\d+ |
lo mismo como regex (modo regex) |
wbf |
fuzzy: las letras en orden, las coincidencias más ajustadas primero (modo fuzzy) |
!running |
las filas que no coinciden |
-l app=web,tier in (a,b),!canary |
las filas cuyos labels coinciden con el selector (se evalúa aquí, al instante) |
-f status.phase=Running |
un field selector, enviado al servidor (una lista propia) |
Se combinan (!running -l app=web). Cada tipo de recurso conserva su último
filtro mientras la UI corre, y el título de la tabla lo muestra. ctrl-z deja
solo las filas que no están bien (en crash, pendientes, no listas); esc borra
las marcas, luego el filtro, y luego vuelve atrás.
Ordenamiento: < y > eligen la columna (una flecha la marca), O la
invierte, N A S ordenan por nombre, antigüedad (las más nuevas primero),
estado como en k9s. Los números se ordenan como números, 2/3 por sus conteos,
512Mi y 250m por tamaño.
Actuar sobre objetos
Sección titulada «Actuar sobre objetos»m abre las acciones de la fila seleccionada como un menú; cada una tiene una
tecla:
| tecla | sobre | hace |
|---|---|---|
enter |
deploy, sts, ds, rs, job, svc, node | sus pods (por su selector, o en el nodo) |
enter |
pod / ns / crd / cronjob | sus contenedores / cambiar a él / sus objetos / sus jobs |
d / y |
cualquier cosa | describe (el de kubectl, con los eventos al final) / YAML (m ahí muestra managedFields) |
e |
cualquier cosa | editar en $EDITOR (abajo) |
ctrl-d, del |
cualquier cosa | borrar, preguntando antes; p ahí elige el cascade (Background, Foreground, Orphan), f sin período de gracia |
ctrl-k |
pod | kill: borrar sin período de gracia (pregunta) |
space |
cualquier cosa | marcar; las acciones se aplican a cada fila marcada (ctrl-\ desmarca) |
l / p |
pod, contenedor, workload, svc | logs / los logs de los contenedores anteriores |
s |
pod, contenedor | una shell (elige el contenedor cuando hay varios) |
s |
deploy, sts, rs | escalar |
r / u / H |
deploy (r: también sts, ds) |
rollout restart / undo (a la revisión anterior) / historial y estado |
F |
pod, svc, deploy, sts, rs | port-forward (el de un service o workload va a uno de sus pods listos) |
f |
los port-forwards (d detiene uno) |
|
t |
cualquier cosa | el árbol del namespace, con el cursor sobre este objeto (t otra vez: volver) |
c / u / r |
node | cordon / uncordon / drain (evictions, respetando los PodDisruptionBudgets; los pods de DaemonSet se quedan) |
T |
cronjob | ejecutarlo ahora (un Job a partir de su template) |
x |
secret / workloads | decodificar sus datos / su árbol xray |
enter, x / s / p / r / R / T |
Application de Argo CD | sus recursos / sync (pregunta) / sync y prune (pregunta) / refresh / hard refresh / terminar el sync en curso (pregunta); ver Applications |
o / J / E |
pod / cualquier cosa con owner / cualquier cosa | su nodo / su owner / sus eventos |
c / C |
cualquier cosa | copiar el nombre / el YAML (OSC 52, así que funciona por SSH) |
n / 0 |
elegir un namespace / todos los namespaces y de vuelta |
Edit funciona como kubectl edit, con el servidor revisándolo primero: el
objeto va a $EDITOR como YAML; lo que vuelve se envía como un dry run
(PUT ?dryRun=All), así que el API server lo valida (schemas, admission
webhooks) sin cambiar nada. Un error vuelve al editor como líneas de comentario
(# Error: ...) encima de tu edición; un cambio válido se muestra como un diff,
que y aplica (e edita de nuevo, esc lo descarta):
╭─ edit deploy/team-0/web (validated by the server; not applied yet) y apply · e edit · esc drop ─╮│@@ -13,7 +13,7 @@ ││ uid: 256ba4d2-d410-42be-99f6-f48045d36606 ││ spec: ││ progressDeadlineSeconds: 600 ││- replicas: 3 ││+ replicas: 4 ││ revisionHistoryLimit: 10 │l sobre un pod con varios contenedores pregunta cuál (o todos); sobre un
deployment, statefulset, daemonset, job o service sigue cada contenedor de cada
pod que selecciona (hasta logs.maxStreams, 30), cada uno con un prefijo de
color, intercalados por tiempo (aquí las líneas de arranque de nginx):
╭─ logs deploy/default/web (all pods) ────────────────── ● follow · 3 streams ─╮│ fjmtf/nginx 2026/10/20 05:02:04 [notice] 1#1: nginx/1.27.5 ││ fjmtf/nginx 2026/10/20 05:02:04 [notice] 1#1: built by gcc 14.2.0 (Alpine 14.││ fjmtf/nginx 2026/10/20 05:02:04 [notice] 1#1: OS: Linux 6.12.113-0-virt ││ fjmtf/nginx 2026/10/20 05:02:04 [notice] 1#1: getrlimit(RLIMIT_NOFILE): 4096:││ fjmtf/nginx 2026/10/20 05:02:04 [notice] 1#1: start worker processes │╰──────────────────────────────────────────────────────────────────────────────╯ esc back f follow / filter t time w wrap p previous ^s save ? helpf pausa y vuelve a seguir, / conserva las líneas que coinciden
(resaltadas; tab para regex o fuzzy), t timestamps, w ajuste de línea,
p los logs de los contenedores anteriores, c copia, ctrl-s guarda en un
archivo (en $TMPDIR/litek8s/), x limpia. El buffer conserva las últimas
logs.buffer líneas (10 000); cada stream empieza con sus últimas logs.tail
líneas (100).
Shells y port-forwards
Sección titulada «Shells y port-forwards»s suspende la UI y abre una shell (bash si la imagen lo tiene, si no ash o
sh) en el contenedor, sobre el WebSocket de exec del API server, redimensionada
con la terminal; al salir vuelves a la misma vista con su código de salida. F
pide local:remote con los puertos del objeto listados (los nombres funcionan:
8080:http); los forwards escuchan en 127.0.0.1 hasta que se detienen o la UI
termina, aparecen como ⇄n en el encabezado, y f los lista con sus conteos
de conexiones.
╭─ xray deployments(all) ──────────────────────────────────────────────────────╮│ ▾ ● deploy default/burner 3/3 ready ││ ▾ ● rs burner-f57f75b8d 3/3 ready, revision 1 ││ ▾ ● pod burner-f57f75b8d-2gpz6 Running 1/1 ││ ● container burn running, ready, busybox:1.36 ││ ▾ ● pod burner-f57f75b8d-qvcq2 Running 1/1 ││ ● container burn running, ready, busybox:1.36 ││ ▾ ● pod burner-f57f75b8d-vfp2z Running 1/1 ││ ● container burn running, ready, busybox:1.36 ││ ▾ ● deploy default/web 3/3 ready ││ ▾ ● rs web-574b8887b7 3/3 ready, revision 1 ││ ▾ ● pod web-574b8887b7-8xkrz Running 1/1 ││ ● container nginx running, ready, nginx:1.27-alpine │╰──────────────────────────────────────────────────────────────────────────────╯enter pliega una rama; d, y, e, l, s, ctrl-d actúan sobre el
objeto de la fila (en la fila de un contenedor: sus logs y su shell); ctrl-r
lo recarga.
Applications de Argo CD
Sección titulada «Applications de Argo CD»:apps (o :applications) lista las Applications de Argo CD con sus columnas
Sync Status y Health Status, coloreadas según ambas (Degraded en rojo; out of
sync, Progressing o Missing en amarillo). Se leen y se manejan solo a través de
la API de Kubernetes, así que esto funciona con Argo CD o con cualquier
controller que reconcilie sus manifiestos argoproj.io, en cualquier cluster:
| tecla | hace |
|---|---|
enter, x |
las apps del namespace hasta sus recursos, a partir del status de cada app: sync y health de cada recurso, el mensaje de health (exceeded its progress deadline), to prune, hooks; una app que gestiona otra app (app of apps) se dibuja debajo de su padre; sigue las apps en vivo (se vuelve a cargar cuando una cambia, conservando el cursor y lo plegado) |
D |
el diff con git: por cada recurso out of sync, faltante o a podar, - en vivo y + en git, solo los campos que define git, con los valores de Secrets enmascarados. Se lee del Secret <app>.diff junto a la app (key diff.json, label gitops.litek8s.dev/diff), que el controller escribe después de cada comparación: {revisions, resources: [{group, version, kind, namespace, name, status, desired, live, omitted}]}, con el objeto en vivo recortado a los campos de desired (más los que definió el último apply), null para el lado que no existe. Argo CD, en cambio, guarda sus diffs en argocd-server (argocd app diff) |
s |
sync: escribe la operation que escribe la CLI de argocd (las sync options de la app, la estrategia de hooks), después de preguntar; se rechaza mientras corre otra operación |
p |
lo mismo con prune: se borra lo que git ya no tiene |
r / R |
refresh / hard refresh (la anotación argocd.argoproj.io/refresh) |
T |
terminar el sync en curso (como argocd app terminate-op), después de preguntar |
╭─ xray applications(argocd) ──────────────────────────────────────────────────╮│ ▾ ✕ app web OutOfSync · Degraded @ 0123456 ││ ✕ deployment web/web OutOfSync · Degraded: exceeded its progress deadli…││ ● service web/web Synced · Healthy ││ ◐ configmap web/old OutOfSync, to prune │╰──────────────────────────────────────────────────────────────────────────────╯ esc back enter fold s sync r refresh d describe ^r reload ? helpArgo CD v3 deja el health de cada recurso fuera del status de la Application
(resourceHealthSource: appTree: vive en la propia cache de Argo CD); donde el
status no lo tiene, el árbol lee el objeto en vivo y lo evalúa como lo hace
Argo CD para los kinds que dicen por qué una app no está Healthy
(Deployments, StatefulSets, DaemonSets, ReplicaSets, Jobs, Pods, PVCs: el
mensaje de un Job fallido, un rollout que pasó su progress deadline, un crash
loop).
En la fila de una app de ese árbol, s, p, r, R, T actúan sobre ella;
en la fila de un recurso, d, y, e, l actúan sobre el objeto; ctrl-r
lo recarga. Los syncs, refreshes y terminaciones son cambios: los clusters de
solo lectura los rechazan como cualquier otro. Las mismas lecturas y acciones
son herramientas de litek8s mcp (applications_list,
application_status, application_sync, application_refresh).
t sobre cualquier lista (o :tree, o t sobre un cluster en la vista
Clusters) muestra lo que imprime litek8s tree --context <ctx>, y lo mantiene
actualizado: los nodos, luego los workloads de cada namespace hasta sus
controllers (CronJob → Job → Pod, Deployment → ReplicaSet → Pod, StatefulSet,
DaemonSet y Job → Pod, pods sin owner) y sus services con cuántos de los pods
que seleccionan están listos. Ambos los dibuja un mismo builder
(src/tree.rs); la UI le pasa las filas que sus informers ya mantienen para
los nueve kinds, así que el árbol no cuesta peticiones propias y cambia a la
par de los watches (un árbol de 5 000 pods se reconstruye en unos 8 ms, como
máximo una vez por segundo mientras los pods siguen cambiando).
╭─ tree all namespaces ─────────────────────────────────────────── 11 objects ─╮│ ├─ ◐ namespace default ││ │ ├─ ◐ Pod solo Pending ││ │ └─ ● Service kubernetes ClusterIP 10.43.0.1 443 ││ ├─ ● namespace kube-system ││ │ └─ ● Service kube-dns ClusterIP 10.43.0.10 53,53 ││ └─ ◐ namespace shop ││ ├─ ● CronJob tick schedule */5 * * * * ││ ├─ ◐ Deployment api 0/3 ready ││ │ └─ ◐ ReplicaSet api-6bcdd669f6 0/3 ready ││ │ ├─ ◐ Pod api-6bcdd669f6-mm7gl Pending ││ │ ├─ ◐ Pod api-6bcdd669f6-mvswq Pending ││ │ └─ ◐ Pod api-6bcdd669f6-wn8fn Pending ││ ├─ ◐ Job once 0/1 done ││ │ └─ ◐ Pod once-927zc Pending ││ └─ ◐ Service api ClusterIP 10.43.0.11 80 → 0/3 pods │╰──────────────────────────────────────────────────────────────────────────────╯ t/esc back space fold enter describe / filter l logs 0 all ns ? helpCada línea tiene el glifo y el color de su estado (corriendo y listo en verde,
pendiente o parcialmente listo en amarillo, en crash o fallido en rojo); un
namespace toma el peor de lo que contiene. space pliega y despliega una rama
(▸ 3 more dice lo que oculta), → despliega, ← pliega o sube al padre;
enter hace describe del objeto (en la línea de un namespace lo pliega), d
y e l s F c ctrl-d actúan sobre él como en las tablas; /
conserva las líneas que coinciden junto con aquello bajo lo que están; 0
alterna entre el namespace y todos, H muestra los ReplicaSets viejos,
ctrl-r vuelve a listar todo, t (o esc) vuelve a la lista. Si se abre con
t sobre un deployment, pod, job…, el cursor empieza en ese objeto. Un cluster
en modo árbol se queda en él cuando cambias de contexto. Una lista que el
cluster rechaza (nodes is forbidden) lo dice arriba y el resto se sigue
mostrando. En un litek8s más viejo cuya Table de Service no tiene columna
Selector, el árbol lee los services como objetos, así que siguen mostrando
→ ready/total pods como lo hace litek8s tree. Tus hotkeys y plugins de
ui.yaml van antes que las teclas integradas: uno asignado a t se la queda.
ui.yaml
Sección titulada «ui.yaml»~/.litek8s/ui.yaml (junto a config.yaml; $LITEK8S_UI_CONFIG para ponerlo
en otro lugar), con todas sus partes opcionales:
aliases: # :cp → pods -n kube-system -l tier=control-plane cp: pods -n kube-system -l tier=control-planehotkeys: # una tecla ejecuta una línea de comando shift-1: ":pods -A" f2: "!get events -A --sort-by=.lastTimestamp"plugins: # tus comandos, sobre la fila seleccionada - name: dive key: ctrl-i scopes: [pods] # nombres de recursos, o all command: dive args: [$COL-IMAGE] # $NAME $NAMESPACE $CONTEXT $RESOURCE $CONTAINER $COL-<COLUMN> - name: stern key: shift-l scopes: [deploy] command: stern args: [-n, $NAMESPACE, $NAME] background: true # salida en un pager en lugar de la terminal confirm: false # true: preguntar antes mutates: false # solo lee: también corre en clusters de solo lecturatheme: default # high-contrast, mono; ver Aspectobackground: auto # dark, lightascii: false # true (o LITEK8S_UI_ASCII=1): solo ASCIIskin: # nombres, 0-255 o #rrggbb, sobre los colores del tema accent: cyan selected: darkgray warn: yellow bad: redlogs: {tail: 100, buffer: 10000, timestamps: false, wrap: false, maxStreams: 30}readOnly: false # true: sin borrados, ediciones, escalado ni shells, en ningún ladowritableContexts: [] # otros clusters que se pueden modificar (W con "remember" los agrega aquí)showOtherContexts: true # false: Clusters lista solo los clusters de litek8skubectl: kubectl # qué kubectl ejecuta `:kubectl`Los hotkeys y plugins se revisan antes que las teclas integradas, así que
pueden quedarse con cualquiera de ellas. Las variables también se pasan a los
plugins como variables de entorno. Los colores de skin van sobre los del tema
(ver Aspecto); NO_COLOR y theme: mono los ignoran. --mouse
selecciona filas con un clic y desplaza con la rueda.
Teclas de Kubernetes
Sección titulada «Teclas de Kubernetes»| dónde | teclas |
|---|---|
| tablas | : comando, / filtro, t árbol, W modo escritura, ! kubectl, ? ayuda, m acciones, enter abrir, esc volver, n namespace, 0 todos los namespaces, space marcar, < > O N A S ordenar, ctrl-w wide, ctrl-z fallas, ctrl-r recargar, f port-forwards, y las acciones |
| pagers (describe, YAML, kubectl, ayuda) | / buscar, n/N coincidencia siguiente/anterior, w ajuste de línea, ←→ desplazamiento lateral, e editar, y/d YAML/describe, m managedFields, c copiar, ctrl-s guardar, esc volver |
| logs | f seguir/pausar, / filtro, t timestamps, w ajuste de línea, p anteriores, c copiar, x limpiar, ctrl-s guardar, esc volver |
| xray | enter plegar, d y e l s ctrl-d sobre la fila, ctrl-r recargar; en la fila de una Application s p r R T |
| tree | t/esc volver, space plegar, ← → plegar/subir y desplegar, enter describe, d y e l s F c ctrl-d sobre la fila, / filtro, 0 todos los namespaces, H ReplicaSets viejos, ctrl-r recargar |
1-8 y tab siguen cambiando de vista, q sale.
Para otras vistas y herramientas
Sección titulada «Para otras vistas y herramientas»Las piezas de la vista Kubernetes están separadas para que otras partes de
litek8s puedan usarlas: kube::ops (una función async por cada acción de la
API), kube::informer (listas compactas y observadas con watch),
kube::describe, y columnas de tabla extra: un mensaje
KMsg::Ext { kind, column, values } agrega una columna (valores por
namespace/name) a cada tabla de ese kind. Las columnas CPU y MEM de
metrics.k8s.io son una de ellas; una vista de observabilidad puede agregar las
suyas (tasas de peticiones, conteos de errores) de la misma forma, sin tocar el
código de la tabla.
Rendimiento de Kubernetes
Sección titulada «Rendimiento de Kubernetes»Las listas se guardan como filas compactas (las celdas del servidor, nombre,
labels, owners; sin spec, status ni anotaciones), leídas directamente de las
páginas de la API hacia ellas; una tabla construye solo las filas que están en
pantalla; el filtrado y el ordenamiento corren sobre las filas en memoria con
cada pulsación de tecla. Medido en una MacBook de la serie M contra un API
server de litek8s sin nodos (litek8s apiserver --no-node) con 50, 1 000 y
5 000 objetos pod (dos contenedores cada uno, 50 namespaces), ambas UIs sobre
los pods de todos los namespaces en una ventana de tmux de 120x40, build de
release, k9s v0.50.16 (Homebrew), 60 s en reposo, RSS y tiempo de CPU de ps
(script de rendimiento: crear los pods con la API, arrancar la UI, esperar la
lista, muestrear, filtrar, salir):
| pods | del arranque a la lista | RSS | CPU en reposo | de la tecla del filtro a la pantalla | |
|---|---|---|---|---|---|
| 50 | litek8s ui | 0.09 s | 19.7 MiB | 0.00 % | 0.5 ms (25 ms en pantalla) |
| k9s | 1.87 s | 101.7 MiB | 0.40 % | (24 ms en pantalla) | |
| 1 000 | litek8s ui | 0.16 s | 29.4 MiB | 0.02 % | 0.6 ms (22 ms en pantalla) |
| k9s | 1.64 s | 153.9 MiB | 3.17 % | (23 ms en pantalla) | |
| 5 000 | litek8s ui | 0.83 s | 61.0 MiB | 0.02 % | 1.0 ms (30 ms en pantalla) |
| k9s | 3.05 s | 359.7 MiB | 15.4 % | (26 ms en pantalla) | |
| 5 000, 10 actualizaciones/s | litek8s ui | 1.23 s | 43.6 MiB | 1.28 % | 0.9 ms (26 ms en pantalla) |
| k9s | – | 361.3 MiB | 15.2 % | (38 ms en pantalla) |
- Arranque va desde que arranca el proceso hasta la lista completa en
pantalla, observado desde afuera cada 10 ms (incluye que
tmuxlo arranque);LITEK8S_UI_STATS=1pone la cifra propia de litek8s en 45 ms, 112 ms y 788 ms (la mayor parte, el API server paginando 5 000 pods). - Tecla del filtro: la primera cifra es la propia de litek8s, desde la tecla
hasta el frame escrito (
LITEK8S_UI_STATS); entre paréntesis, desdetmux send-keyshasta untmux capture-paneque cambió, que no puede bajar de unos 22 ms: ambas UIs están en ese piso. - En reposo: pods asignados a un nodo que no existe, así que nada cambia. Las dos últimas filas son pods que el scheduler del servidor sigue reintentando (unas 10 actualizaciones de pods por segundo con 5 000 pods): litek8s envía una tabla como máximo una vez por segundo mientras siguen llegando cambios y solo entonces redibuja; k9s vuelve a renderizar sus tablas cada 2 s, haya cambiado algo o no.
- Por SSH en omarchy (Linux x86_64, cluster de desarrollo rootless, tabla de pods de un namespace con dos pods corriendo, 100x30): 0 ticks de CPU en 60 s, 24 MiB de RSS, 2 hilos.
Cómo se comunica con litek8s
Sección titulada «Cómo se comunica con litek8s»Solo a través de lo que litek8s ya sirve, así que un litek8s remoto se ve igual:
| qué | de dónde |
|---|---|
| contenedores, imágenes, volúmenes, tamaños, logs, exec, prune | la API de Docker Engine en el socket (GET /containers/json, /system/df, /events, POST /exec/{id}/start convertido en un stream raw, …) |
| tipos de recurso | descubrimiento: agregado (/api, /apis como APIGroupDiscoveryList, dos peticiones), si no, los documentos legacy por grupo |
| cada lista | ?limit=2000&includeObject=Metadata como una Table del lado del servidor (as=Table;g=meta.k8s.io), luego un watch desde su resourceVersion (también Tables) |
| describe, YAML, edit, delete, scale, rollouts, cordon, drain | GET, PUT (con ?dryRun=All primero para las ediciones), DELETE con propagationPolicy, PATCH .../scale, merge patches y JSON patches, POST .../eviction |
| logs | .../log?follow=true×tamps=true&tailLines=N por pod y contenedor |
| shell | GET .../exec convertido en un WebSocket (v5.channel.k8s.io, si no v4.channel.k8s.io) |
| port-forward | POST .../pods/{name}/portforward convertido en SPDY/3.1 (portforward.k8s.io), una sesión por conexión local, escuchando en 127.0.0.1 |
| columnas de CPU y memoria | metrics.k8s.io (cuando el cluster lo sirve), cada 15 s mientras se muestran pods o nodos |
:kubectl, plugins |
kubectl --context <el contexto de la UI>, el comando del plugin, como procesos hijos |
| estado, CPU, memoria, disco del cluster de desarrollo | el archivo de estado del supervisor de desarrollo (dev.json: modo, puerto, pid, cgroup o proceso de la VM, con qué arrancó), su cgroup o el proceso de la VM |
| up, down, delete, nuevo cluster | litek8s dev up/down/delete --name <cluster>, ejecutado como proceso hijo (su salida aparece en Home y Clusters) |
| los clusters locales, su memoria | los archivos de los clusters en el directorio de datos de desarrollo (cluster.json, dev.json), una petición a la VM o al sandbox (env.sock) para la memoria de todos los clusters, GET /api/v1/nodes de cada uno en ejecución para sus nodos Ready |
litek8s ui --docker-host tcp://10.0.0.5:2375 --context remote # otro litek8slitek8s ui --docker-host unix:///run/user/1000/litek8s.sock # p. ej. un socket reenviado con ssh -Llitek8s ui -n demo # empezar en un namespaceSin flags, la UI sigue al cluster de desarrollo de esta máquina: el lado de Kubernetes usa el puerto de API que registró el cluster en ejecución (y se reconecta cuando cambia), y dice “not running” en lugar de recurrir a lo que sea que escuche en 6443.
Apps: Argo CD y litecd
Sección titulada «Apps: Argo CD y litecd»La vista 0 aparece en los clusters que sirven el CRD Application de Argo CD
(applications.argoproj.io), sea quien sea que lo reconcilie: Argo CD, o
litecd, que lee y escribe los mismos objetos. Reemplaza lo básico de la UI web
de Argo CD con nada más que la API de Kubernetes: la lista, los recursos y el
historial de una app, y las acciones, que hacen patch a la Application como lo
hace la CLI de argocd, así que funcionan con cualquiera de los dos controllers
y no necesitan el API server de ninguno ni un login.
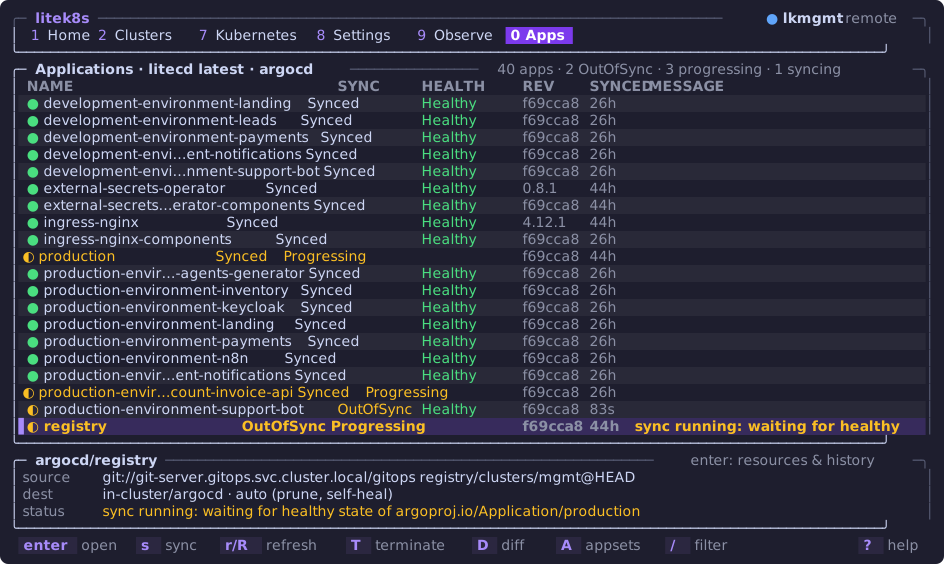
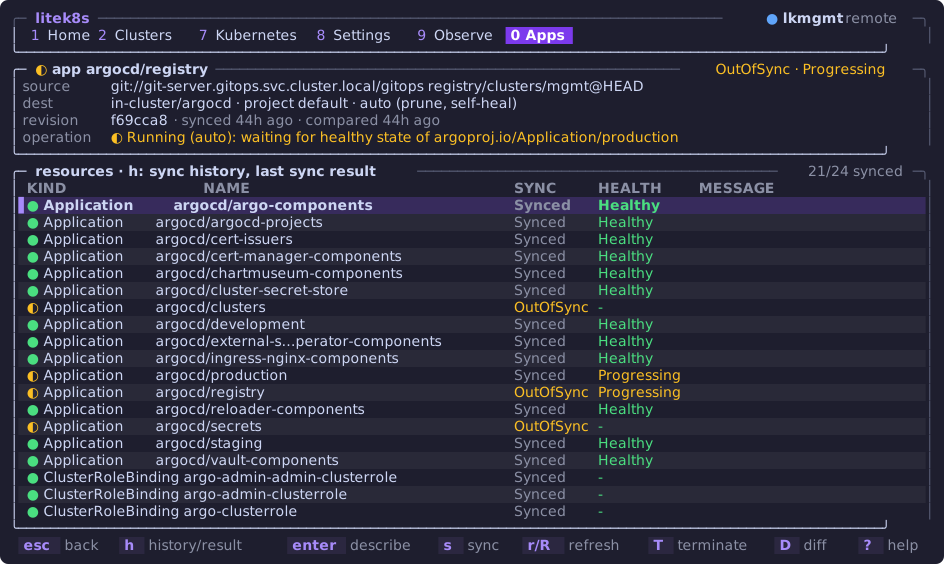
litek8s 1 Home 2 Clust 7 Kube 8 Set 9 Obs 0 Apps ● lkmgmt · remote╭─ Applications · litecd latest · argocd ────────────── 40 apps · 2 OutOfSync ─╮│ NAME SYNC HEALTH REV SYNCED MESSAGE ││▌● argo Synced Healthy 0.20.1 5h ││ ● cert-manager Synced Healthy v1.14.4 23h ││ ◐ development Synced Progressing f69cca8 23h ││ ● developme…nt-groveback Synced Healthy f69cca8 5h ││ ◐ production-env…ifybot OutOfSync Healthy f69cca8 3m ││ ◐ registry OutOfSync Progressing f69cca8 23h sync running…││ ✕ web OutOfSync Degraded 0123456 9m sync failed:…│╰──────────────────────────────────────────────────────────────────────────────╯╭─ argocd/argo ─────────────────────────────────── enter: resources & history ─╮│ source https://argoproj.github.io/argo-helm argo-workflows@0.20.1 ││ dest in-cluster/argo · auto (prune, self-heal) ││ status Synced · Healthy compared 11s ago │╰──────────────────────────────────────────────────────────────────────────────╯ enter open s sync r/R refresh T terminate D diff A appsets ? help- La lista: cada Application de cada namespace, por nombre. El glifo es el
health y el sync juntos (
✕Degraded,◐Progressing, Missing, out of sync o sincronizando,●Synced y Healthy);REV, la revisión con la que está sincronizada (los primeros 7 caracteres de un commit, la versión de un chart),SYNCED, cuándo terminó su última operación (si no, el último deploy de su historial), y el mensaje de una operación en curso o fallida, si no su primera condición, si no su mensaje de health. El título dice qué controller las ejecuta (el Deployment o StatefulSet en el namespace del controller de las apps: litecd, o el application controller de Argo CD, con el tag de su imagen); el lado derecho cuenta las apps, las degradadas, out of sync, progressing y sincronizando. Debajo de la lista, la(s) fuente(s), el destino y la sync policy de la app seleccionada. Las terminales anchas (140 columnas) agregan el proyecto y una fuente abreviada./filtra por nombre, namespace, proyecto, sync o health (/OutOfSync). Acambia a los ApplicationSets (cuando hay alguno): sus generators, cuántas apps tiene cada uno, y una condición de error si hay una definida.enterabre la app: su(s) fuente(s), destino, proyecto y policy, la revisión, cuándo se sincronizó y cuándo se comparó por última vez, la operación (fase, quién la inició, su mensaje), el mensaje de health y las condiciones; debajo, los recursos de su status con su sync y su health (requires pruning, hooks). Argo CD v3 deja el health de los recursos fuera del status (resourceHealthSource: appTree); ahí se lee de los objetos en vivo (como lo hace el árbol de la vista Kubernetes) mientras la app está abierta, y las Applications hijas (app of apps) toman el health de su propio status.halterna la lista entre los recursos, el historial de sync (los más nuevos primero: id, revisión, cuándo, por quién oauto, fuente) y el resultado del último sync (el resultado y el mensaje de cada recurso).entersobre un recurso hace describe de él en la vista Kubernetes;escahí vuelve.Del diff con git (el Secret del diff publicado que escribe litecd; Argo CD guarda el suyo en argocd-server),del describe de la Application, ambos en la vista Kubernetes;escvuelve.
Acciones, sobre la app seleccionada (lista) o la abierta:
| tecla | hace |
|---|---|
s |
sync: un diálogo dice qué hace; p activa prune (borra lo que git ya no tiene), f force (borra y vuelve a crear lo que no se puede parchear, como argocd app sync --force); y escribe la operation que escribe la CLI de argocd (las sync options de la app, la estrategia de hooks, prune, hook.force), n/esc cancela. Se rechaza mientras corre otra operación. force es solo de Argo CD: litecd no tiene force sync, así que ahí el diálogo lo omite |
r / R |
refresh / hard refresh: la anotación argocd.argoproj.io/refresh (normal, hard: volver a renderizar los manifiestos) |
T |
terminar el sync en curso (como argocd app terminate-op: su fase pasa a Terminating), después de preguntar; solo mientras hay uno en curso. Solo Argo CD: litecd no puede terminar un sync, y la vista lo dice |
Son cambios, así que siguen la regla de la vista Kubernetes: permitidos en
clusters de litek8s, rechazados (y el pie dice por qué) en otros contextos a
menos que W o writableContexts los permitan, y en todas partes con
readOnly: true. La vista lista /apis/argoproj.io/v1alpha1/applications y
.../applicationsets cada 5 s mientras está en pantalla y nunca en otro caso
(una vez más justo después de una acción); el controller se busca una vez por
cluster (list sobre los Deployments y StatefulSets de su namespace; sin ese
permiso dice controller unknown). En un cluster sin el CRD la pestaña no
aparece y 0 dice por qué.
Ligera para la máquina
Sección titulada «Ligera para la máquina»La UI dibuja solo cuando una tecla, un cambio de tamaño de la ventana o datos nuevos cambian lo que hay en pantalla, y si no, espera en los sockets:
- Sin polling para las listas. Los contenedores, imágenes y volúmenes se
vuelven a listar solo después de eventos de Docker (
GET /events), agrupados en 150 ms; los tamaños (/system/df, que recorre directorios) solo después de eventos que los cambian y como máximo cada 2 s. El uso de los proyectos de compose frente a sus presupuestos es la excepción: cada 2 s mientras Containers está en pantalla, nunca en otro caso. Los pods, deployments y namespaces vienen de watches de Kubernetes, agrupados en 100 ms. - Clusters lista los clusters cada 2 s mientras la vista está en pantalla (sus archivos, una petición de memoria a la VM o al sandbox, una lista de nodos de cada cluster en ejecución) y nunca en otro caso: a un cluster que nadie mira no se le hace polling.
- Los desgloses de Home vienen con sus muestras: contadores de memoria y CPU cada 2 s mientras Home está en pantalla (en la Mac, una petición por el canal de control de la VM), las categorías de disco cada 30 s a partir de un recorrido que el API server repite como máximo una vez por minuto; nada mientras Home está oculto. Medido en omarchy, Home con la caja de CPU sobre un pod ocupado: 0.08 % de CPU, 1.8 wake-ups/s, 18 MiB de RSS.
- Home muestrea el estado, la CPU y la memoria del cluster mostrado cada 2 s mientras Home o Free space están en pantalla, cada 10 s en Settings (para su nota de reinicio), cada 60 s en otro caso (para notar que el puerto de la API cambió); el tamaño del directorio de datos (un recorrido de directorios) como máximo cada 30 s y solo mientras se muestra. Cuando el engine está caído se reintenta con backoff hasta 10 s.
- El aspecto no agrega ningún timer: los gráficos de historial de Home se llenan con sus propias muestras de 2 s mientras está en pantalla, y el fondo de la terminal se pregunta una vez, antes del primer frame (ver Aspecto).
- La entrada viene del stream de eventos de crossterm, que espera en el lector de la terminal (sin timer); mientras una shell o un editor tiene la terminal, el stream se descarta, así que nada más lee las pulsaciones. Los únicos timers son un mensaje de estado que se desvanece después de 8 s y, en las vistas que muestran antigüedades, un redibujado cada 30 s.
- Dos hilos:
litek8s uicorre en un runtime async de un solo hilo (los servidores del mismo binario usan un hilo por core) más el lector de terminal de crossterm; un hilo del blocking pool aparece y desaparece para el recorrido del directorio de datos. La vista de logs conserva las últimas 5000 líneas, cada una cortada a 4096 caracteres.
Medido en Linux x86_64 (omarchy, build de release, cluster de desarrollo
rootless con un proyecto de compose de 3 contenedores y un deployment de 3
réplicas, 80x24 en tmux, después de dos cambios de tamaño de la ventana), en
reposo 60 s en cada vista; la CPU de /proc/<pid>/stat, los wake-ups son los
cambios de contexto voluntarios de todos sus hilos:
| vista | CPU | wake-ups | RSS | hilos |
|---|---|---|---|---|
| Home (muestras cada 2 s) | 0.07 % | 3.6/s | 16.5 MiB | 3 (el hilo bloqueante del recorrido de tamaños) |
| Clusters (2 clusters, uno con 3 nodos; cada 2 s) | 0.08 % | 2.3/s | 17.3 MiB | 2 |
| Containers | 0.00 % | 0.3/s | 16.5 MiB | 2 |
| Kubernetes | 0.02 % | 0.4/s | 16.5 MiB | 2 |
| Settings | 0.02 % | 1.0/s | 16.6 MiB | 2 |
| un log que sigue 1 línea/s | 0.03 % | 2.4/s | 19.1 MiB (pico) | 2 |
(La fila de Clusters es de una ronda posterior con clusters con nombre, misma máquina y mismo método; en esa ronda Home midió 0.03 % y 1.8/s, Containers 0.00 % y 0.1/s: con Clusters fuera de pantalla, nada muestrea los clusters.)
En macOS (MacBook de la serie M, litek8s dev up --cpus 4 --memory 4096, el
mismo workload, 80x24 en tmux), en reposo 60 s en cada vista; la CPU del
tiempo de CPU de ps, los wake-ups en reposo y el footprint (lo que el
Monitor de Actividad llama Memoria) de top:
| vista | CPU | wake-ups en reposo | footprint | RSS | hilos |
|---|---|---|---|---|---|
| Home (muestras cada 2 s) | 0.12 % | 0.02/s | 6.5 MiB | 20.2 MiB | 3 |
| Containers | 0.00 % | 0.02/s | 6.5 MiB | 20.2 MiB | 2 |
| Kubernetes | 0.02 % | 0.02/s | 6.5 MiB | 20.2 MiB | 2 |
| Settings | 0.02 % | 0.02/s | 6.5 MiB | 20.2 MiB | 2 |
| un log que sigue 1 línea/s | 0.07 % | 0.03/s | 6.6 MiB | 20.2 MiB | 2 |
(El RSS cuenta las páginas compartidas del binario de 39 MB; el footprint es la memoria propia de la UI.)
Arranque: en Linux el primer frame se dibuja 0.7 ms después de que arranca la
UI, y el primero con los contenedores del engine, 2.7 ms después; en la Mac,
1.6-2.8 ms y 7-13 ms (el socket de Docker se retransmite a la VM por vsock).
LITEK8S_UI_STATS=1 litek8s ui imprime estas cifras, y la cantidad de frames
dibujados, al salir: 156 frames en 315 s para la ejecución en Linux de arriba,
casi todos muestras de Home y líneas de log.
Tamaño: la UI (ratatui y crossterm, ninguna otra dependencia nueva) le agrega al binario de release:
| main (c47079e) | con la UI | diferencia | |
|---|---|---|---|
| macOS arm64, stripped | 30.86 MB | 32.43 MB | +1.49 MiB |
| macOS arm64, tal como se compila | 37.39 MB | 39.28 MB | +1.80 MiB |
| Linux x86_64, stripped | 35.95 MB | 37.63 MB | +1.61 MiB |
| Linux x86_64, tal como se compila (con símbolos) | 45.49 MB | 47.65 MB | +2.06 MiB |
La mayor parte es el código propio de la UI (unos 650 KiB de símbolos); ratatui y crossterm son unos 200 KiB.
La UI de cluster de la vista Kubernetes (src/ui/kube) agrega 1.92 MiB más al binario stripped de macOS arm64 (33.41 MB en main c620693, 35.43 MB con ella; 40.37 → 42.76 MB tal como se compila), sin ninguna dependencia nueva. El aspecto (src/ui/theme.rs) agrega 70 KiB en macOS y 12 KiB en Linux.
| dónde | teclas |
|---|---|
| en todas partes | 1-9, 0/tab/shift-tab vistas, ↑↓/jk/PgUp/PgDn/g/G moverse, / filtrar la lista (esc lo borra), ctrl-r refrescar, ? ayuda, q o ctrl-c salir |
| Home | u up, d down (pregunta), R borrar el cluster (pregunta), b el siguiente desglose (memoria, CPU, disco), c copiar la dirección de la API |
| Clusters | n nuevo (tab entre nombre y nodos), u up, d down (pregunta), D/del borrar (pregunta), enter mostrarlo (un cluster local: todas las vistas, luego pregunta por kubectl/docker; otro contexto: la vista Kubernetes), t directo a su árbol, c copiar el nombre de su contexto |
| Containers | l/enter logs, s shell, u iniciar, x detener (pregunta), r reiniciar (pregunta), d/del eliminar (pregunta), space plegar un proyecto |
| Images, Volumes | d/del eliminar (pregunta) |
| Free space | space seleccionar una categoría, p/enter liberar lo seleccionado (pregunta) |
| Kubernetes | ver sus teclas; ? ahí lista las de lo que se muestra |
| Settings | enter editar, del volver al valor por defecto, space alternar / cambiar un contexto |
| Observe | l/enter los logs del pod, L buscar en los logs de todos los pods, s ordenar por CPU/memoria, n/N namespace, a reconocer las alertas del pod, A todas (pregunta) |
| Apps | enter abrir la app (esc volver), h recursos / historial de sync / último resultado, s sync (p prune, f force; pregunta), r/R refresh / hard refresh, T terminar el sync (pregunta), D diff, d describe, A ApplicationSets; sobre un recurso, enter hace describe de él |
| logs | f seguir, w ajuste de línea, c limpiar, esc volver |
--mouse activa los clics (pestañas, filas) y la rueda; está desactivado por
defecto porque toma el control de la selección de texto propia de la terminal.
Copiar: c pone el texto mostrado en el portapapeles (OSC 52, que llega a las
terminales por SSH y tmux, y pbcopy en una Mac); en la vista Kubernetes c
copia un nombre y C un YAML. La selección propia de la terminal también
funciona, pero la pantalla se redibuja cada 2 s, lo que puede borrarla en
algunas terminales; en macOS, arrastrar con option selecciona incluso con
--mouse.
Límites
Sección titulada «Límites»- Describe es el de kubectl para pods, deployments, nodos y services, y su forma genérica (campos como keys en “Title Case”) para todos los demás tipos.
- El rollout undo y el historial son para deployments (no se leen las ControllerRevisions de StatefulSets y DaemonSets).
- Con
publish: alllos puertos escuchan en todas las interfaces, perodocker pstodavía los muestra como127.0.0.1:<port>: el engine en la VM o el sandbox no sabe dónde escucha el lado del host. - Los exec credential plugins que devuelven certificados de cliente (en lugar
de un token) no están soportados;
auth-providersolo con un token en el kubeconfig (elid-tokende OIDC).